Chuyển giọng nói thành văn bản
Module thông minh nhận dạng giọng nói của Xeoma
 Module này "lắng nghe" luồng âm thanh từ camera hoặc micro riêng biệt, nhận dạng lời nói, phản hồi theo từ khóa và lưu bản ghi cuộc hội thoại vào báo cáo CSV hoặc hiển thị dưới dạng văn bản trên video trực tiếp/video lưu trữ tùy theo thiết lập của bạn. Module cũng có thể chuyển đổi thành văn bản các tệp .mp3 như bản ghi âm hội thoại, video đào tạo, v.v.

Quan trọng: phiên bản beta
Module khả dụng từ phiên bản Xeoma 24.8.12 và đang trong giai đoạn beta, nên đôi khi có thể bỏ sót từ hoặc bị lặp. Không yêu cầu thiết bị chuyên dụng: chỉ cần luồng âm thanh từ bất kỳ camera hoặc micro nào cùng một máy tính phổ thông có GPU là đủ đáp ứng.
Kịch bản ứng dụng
Tính năng Chuyển giọng nói thành văn bản giúp tăng cường an ninh trong đời sống cá nhân, quản lý đô thị và cộng đồng dân cư, cũng như trong lĩnh vực thương mại, đồng thời góp phần tối ưu hóa vận hành doanh nghiệp.
Chăm sóc người cao tuổi
Khả năng phản ứng tức thì với tiếng kêu cứu hoặc bảo vệ họ khỏi những kẻ lừa đảo.
Mọi loại hình doanh nghiệp
Kiểm soát tự động chất lượng dịch vụ khách hàng (ví dụ: phát hiện ngôn từ thô tục).
Trung tâm cuộc gọi (Call center)
Chuyển đổi bản ghi âm cuộc gọi thành văn bản để giám sát việc tuân thủ chính sách công ty và kịch bản hội thoại.
Giám sát thành phố
An ninh chống khủng bố và nhận dạng các từ ngữ cảnh báo nguy hiểm.
Kiểm soát phụ huynh
Hỗ trợ bảo vệ trẻ em khỏi nạn bắt nạt hoặc giao tiếp với kẻ lừa đảo.
Cảnh sát
Kết hợp cùng camera gắn người — chuyển đổi hội thoại với nghi phạm thành văn bản và phát hiện mối đe dọa.
Nghiên cứu và phân tích
Thu thập thống kê nền cho các nghiên cứu về ngôn ngữ nói và tần suất sử dụng từ vựng.
Marketing
Xác định xem khách hàng có đang thảo luận về chiến dịch quảng bá, phản ứng của họ đối với banner, v.v.
Lọc và tự động hóa
Phát hiện các cụm từ không mong muốn hoặc từ khóa trọng tâm để kiểm soát hội thoại theo mục tiêu — mà không cần phải nghe toàn bộ.
Ưu điểm của module Chuyển giọng nói thành văn bản
Không yêu cầu thiết bị đặc thù
Hoạt động trên máy tính phổ thông với hầu hết mọi loại camera và card đồ họa.
Linh hoạt tuyệt đối
Đa dạng phương thức phản hồi (bao gồm cả tùy biến lập trình) và tích hợp với hệ thống bên thứ ba.
Xử lý thời gian thực
Xử lý luồng dữ liệu tức thời, không độ trễ. Vận hành ngay trên phần cứng của bạn.
Giải pháp tiết kiệm chi phí
Có thể mua thêm module này ngoài giấy phép Standard hoặc Pro.
Cách thức hoạt động
Thiết lập chuỗi xử lý
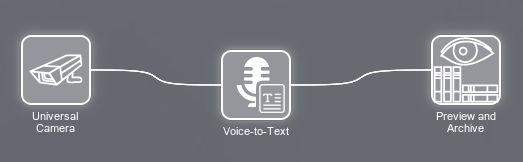
Vì module xử lý luồng âm thanh, bạn cần có nguồn âm thanh trong chuỗi.
- Nguồn âm thanh: micro tích hợp sẵn trong camera, hoặc micro USB/IP rời
- Chuỗi mẫu: “Universal Camera” – “Voice-to-Text” – “Preview and Archive”
- Module được cấp phép bổ sung cho giấy phép Xeoma Pro hoặc Standard
Tải xuống tài nguyên AI
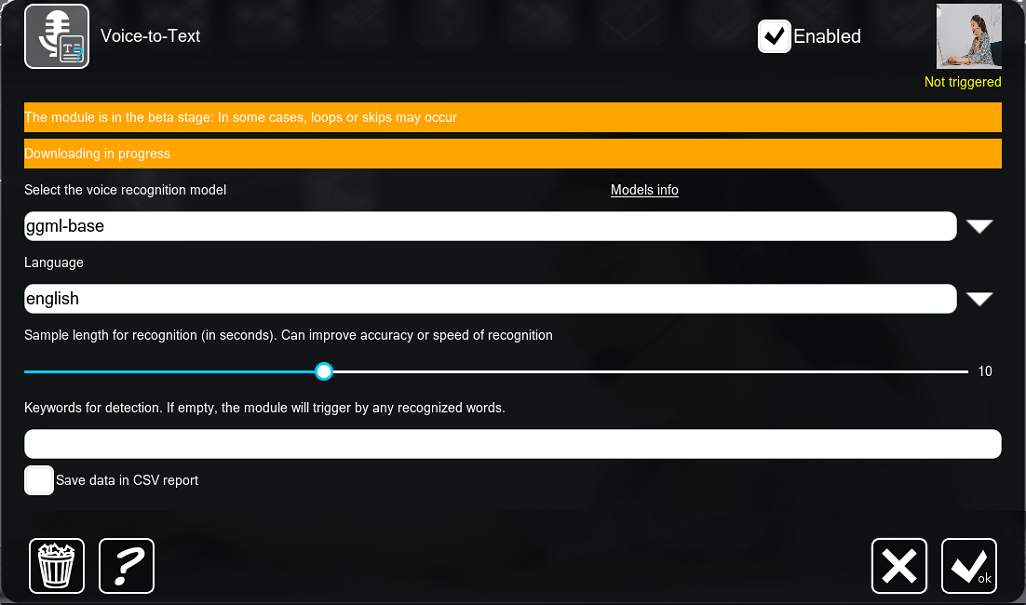
Nhấp vào biểu tượng Chuyển giọng nói thành văn bản trong chuỗi để mở cài đặt module. Quá trình tải tài nguyên bổ sung sẽ tự động bắt đầu khi bạn mở cài đặt lần đầu. Khi thông báo "Đang tải xuống" biến mất, hệ thống đã sẵn sàng.
- Tài nguyên bổ sung chứa các tập dữ liệu trí tuệ nhân tạo và được tải xuống theo yêu cầu từ máy chủ FelenaSoft
- Tài nguyên chỉ được tải khi cần thiết — giúp tối ưu dung lượng phần mềm
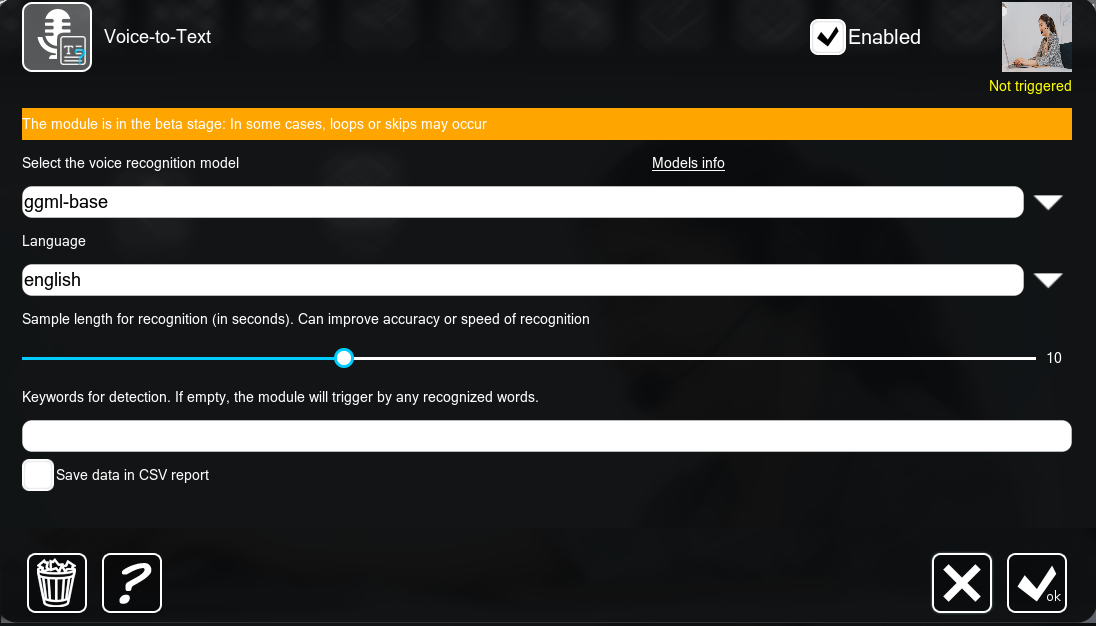
Chọn mô hình nhận dạng và từ khóa
Nhiều mô hình AI khả dụng cho các ngôn ngữ khác nhau, khác biệt về kích thước, chất lượng nhận dạng và mức độ tải phần cứng. Trong trường “Speech recognition model”, chọn ngôn ngữ của bản ghi chép (không cần chỉ định ngôn ngữ nói) và nếu cần, nhập các từ khóa cần phát hiện vào trường bên dưới. Các công tắc “Display of recognized speech during real-time viewing” và “Save recognized speech in subtitles when recording/exporting the archive” cho phép chèn bản ghi chép lên video trực tiếp và trong kho lưu trữ.
- “Keywords for detection” — mô-đun chỉ phản hồi với các từ hoặc cụm từ bạn yêu cầu
- Hiển thị bản ghi chép khi xem trực tiếp và trong kho lưu trữ
- “Save data in CSV report” — lưu bản ghi chép vào tệp bảng tính trên ổ đĩa
- Cấu hình hành động sau mô-đun: ghi hình, thông báo, gửi lệnh
- Macro
%VOICE%khả dụng trong các mô-đun “HTTP Request Sender”, “Email Sending” và “Application Runner”
Tích hợp với phần mềm bên ngoài
Tính năng Voice-to-Text có thể được sử dụng từ các chương trình bên ngoài — ví dụ: để chuyển đổi cuộc gọi VoIP thành văn bản. Chỉ cần cung cấp tệp .mp3 cho mô-đun để nhận kết quả dạng văn bản — ngay cả trên máy trạm không cài đặt Xeoma hay camera. Lưu ý: chỉ hỗ trợ tệp .mp3.
Ví dụ yêu cầu qua Xeoma API (JSON):
curl -F "audio_file=@speech.mp3" "http://192.168.0.67:10090/api?login=Administrator&password=123&speech_recognition=recognition&model=qwen3-asr-1.7b&ttl=10&language=en"
Trong đó:
audio_file=@speech.mp3— đường dẫn đến tệp âm thanh trên máy tính192.168.0.67— địa chỉ IP của máy chủ Xeoma10090— cổng máy chủ XeomaAdministrator/123— tên đăng nhập Quản trị viên (luôn là Administrator) và mật khẩumodel=…— mô hình nhận dạng (xem danh sách bên dưới)language=en— ngôn ngữ của bản ghi chép. Nếu khác với ngôn ngữ nói thực tế, bản ghi chép sẽ tự động được dịch sang ngôn ngữ đã chọn
Để lưu kết quả ra tệp văn bản, thêm >savetext.txt vào cuối lệnh, trong đó savetext.txt là tên tệp văn bản.
Các mô hình nhận dạng cho API:
| Tên | Mô tả | Mã API |
|---|---|---|
| Russian basic | 140 MB | tone |
| Russian enhanced | dấu câu, 215 MB | giga |
| English basic | 70 MB | zipformer |
| Multilingual basic | có dấu câu, 1 GB, 0.6B tham số | qwen3-asr-0.6b |
| Multilingual enhanced | có dấu câu, 2.2 GB, 1.7B tham số | qwen3-asr-1.7b |
Danh sách mã ngôn ngữ
en — Tiếng Anh, zh — Tiếng Trung, de — Tiếng Đức, es — Tiếng Tây Ban Nha, ru — Tiếng Nga, ko — Tiếng Hàn, fr — Tiếng Pháp, ja — Tiếng Nhật, pt — Tiếng Bồ Đào Nha, tr — Tiếng Thổ Nhĩ Kỳ, pl — Tiếng Ba Lan, ca — Tiếng Catalan, nl — Tiếng Hà Lan, ar — Tiếng Ả Rập, sv — Tiếng Thụy Điển, it — Tiếng Ý, id — Tiếng Indonesia, hi — Tiếng Hindi, fi — Tiếng Phần Lan, vi — Tiếng Việt, he — Tiếng Do Thái, uk — Tiếng Ukraina, el — Tiếng Hy Lạp, ms — Tiếng Mã Lai, cs — Tiếng Séc, ro — Tiếng Romania, da — Tiếng Đan Mạch, hu — Tiếng Hungary, ta — Tiếng Tamil, no — Tiếng Na Uy, th — Tiếng Thái, ur — Tiếng Urdu, hr — Tiếng Croatia, bg — Tiếng Bulgaria, lt — Tiếng Litva, la — Tiếng Latinh, mi — Tiếng Maori, ml — Tiếng Malayalam, cy — Tiếng Wales, sk — Tiếng Slovak, te — Tiếng Telugu, fa — Tiếng Ba Tư, lv — Tiếng Latvia, bn — Tiếng Bengal, sr — Tiếng Serbia, az — Tiếng Azerbaijan, sl — Tiếng Slovenia, kn — Tiếng Kannada, et — Tiếng Estonia, mk — Tiếng Macedonia, br — Tiếng Breton, eu — Tiếng Basque, is — Tiếng Iceland, hy — Tiếng Armenia, ne — Tiếng Nepal, mn — Tiếng Mông Cổ, bs — Tiếng Bosnia, kk — Tiếng Kazakh, sq — Tiếng Albania, sw — Tiếng Swahili, gl — Tiếng Galicia, mr — Tiếng Marathi, pa — Tiếng Punjabi, si — Tiếng Sinhala, km — Tiếng Khmer, sn — Tiếng Shona, yo — Tiếng Yoruba, so — Tiếng Somali, af — Tiếng Afrikaans, oc — Tiếng Occitan, ka — Tiếng Georgia, be — Tiếng Belarus, tg — Tiếng Tajik, sd — Tiếng Sindhi, gu — Tiếng Gujarati, am — Tiếng Amharic, yi — Tiếng Yiddish, lo — Tiếng Lào, uz — Tiếng Uzbek, fo — Tiếng Faroe, ht — Tiếng Creole Haiti, ps — Tiếng Pashto, tk — Tiếng Turkmen, nn — Tiếng Nynorsk, mt — Tiếng Malta, sa — Tiếng Phạn, lb — Tiếng Luxembourg, my — Tiếng Myanmar, bo — Tiếng Tây Tạng, tl — Tiếng Tagalog, mg — Tiếng Malagasy, as — Tiếng Assamese, tt — Tiếng Tatar, haw — Tiếng Hawaii, ln — Tiếng Lingala, ha — Tiếng Hausa, ba — Tiếng Bashkir, jw — Tiếng Java, su — Tiếng Sunda, yue — Tiếng Quảng Đông.
Cách kiểm tra
Tải xuống và khởi chạy Xeoma. Sử dụng Phiên bản dùng thử hoặc kích hoạt giấy phép Xeoma Standard/Xeoma Pro cùng giấy phép mô-đun bổ sung “Voice-to-text”.
Thêm camera thủ công hoặc chờ Xeoma tự động tìm kiếm camera trong mạng của bạn. Đối với micrô rời, hãy kết nối mô-đun “Microphone” và chọn nguồn âm thanh phù hợp.
Thêm mô-đun “Voice-to-Text” vào chuỗi xử lý, thiết lập phản ứng theo từ khóa hoặc chuyển lời nói thành văn bản liên tục, đồng thời bật lớp phủ bản chép trên hình ảnh camera và bản ghi nếu cần.
Thiết lập phản ứng khi sự kiện xảy ra — lưu vào CSV, gửi thông báo di động hoặc bất kỳ hành động nào khác.
giấy phép demo
Các mô-đun xử lý luồng âm thanh khác
Các mô-đun này có thể hoạt động độc lập hoặc kết hợp cùng Voice-to-Text.
Chọn micrô USB hoặc micrô IP riêng làm nguồn âm thanh.
Phân tích luồng âm thanh và kích hoạt cảnh báo khi mức âm lượng vượt quá ngưỡng quy định.
Nhận diện còi báo động ô tô, tiếng trẻ em khóc, tiếng súng, tiếng hét và tiếng kính vỡ.
Voice-to-Text: Nhận diện giọng nói trong Xeoma
Trải nghiệm Xeoma miễn phí
Nhập tên và email để nhận giấy phép demo miễn phí. Không cần thẻ tín dụng.
Nhận giấy phép demo Xeoma miễn phí qua email
Đầy đủ tính năng. Gửi ngay lập tức.
Chúng tôi khuyến cáo bạn không sử dụng email chứa dữ liệu cá nhân, cũng như không gửi dữ liệu cá nhân cho chúng tôi dưới bất kỳ hình thức nào khác. Tuy nhiên, nếu bạn vẫn thực hiện, việc gửi biểu mẫu này đồng nghĩa với việc bạn xác nhận đồng ý với việc xử lý dữ liệu cá nhân của mình
Bạn cần hỗ trợ thêm?
Mô-đun chưa hoàn toàn đáp ứng yêu cầu của bạn? Chúng tôi có thể phát triển các chức năng riêng biệt và tích hợp vào Xeoma dưới dạng dịch vụ phát triển tùy chỉnh có phí. Xem chi tiết.
Có câu hỏi? Cần trợ giúp? Hãy liên hệ với chúng tôi! Chúng tôi rất sẵn lòng hỗ trợ!
Sẵn sàng bắt đầu?
Trải nghiệm Voice-to-Text với giấy phép demo miễn phí — không yêu cầu thẻ tín dụng hay dữ liệu cá nhân.