
Trascrizione vocale
Modulo intelligente Xeoma per il riconoscimento vocale
 Il modulo "ascolta" il flusso audio di una telecamera o di un microfono separato, riconosce il parlato, reagisce a parole chiave e salva la trascrizione delle conversazioni in un report CSV oppure la sovrappone come testo al video live o all'archivio, in base alle preferenze. Può trascrivere anche file .mp3: registrazioni di conversazioni, video formativi, ecc.

Importante: versione beta
Il modulo è disponibile a partire da Xeoma 24.8.12 ed è in versione beta; pertanto, in alcuni casi potrebbe saltare parole o generare loop. Non è richiesta attrezzatura specializzata: sono sufficienti il flusso audio di qualsiasi telecamera o microfono e un comune PC dotato di GPU.
Scenari di applicazione
Voice-to-Text potenzia la sicurezza nella vita privata, urbana e civile, oltre che in ambito commerciale, ottimizzando le operazioni aziendali.
Assistenza agli anziani
Capacità di reagire istantaneamente a una richiesta di aiuto o di proteggerli dalle truffe.
Qualsiasi business
Monitoraggio automatizzato della qualità del servizio clienti (ad esempio, rilevamento di linguaggio offensivo).
Call center
Trascrizione delle registrazioni telefoniche per monitorare la conformità alle policy aziendali e agli script di conversazione.
Videosorveglianza urbana
Sicurezza antiterrorismo e riconoscimento di parole indicative di pericolo.
Parental control
Supporto nella protezione dei minori contro bullismo o tentativi di truffa.
Forze dell'ordine
Oltre alle body cam: trascrizione delle conversazioni con i sospettati e rilevamento delle minacce.
Ricerca e analisi
Raccolta statistica in background per studi linguistici e analisi della frequenza d'uso delle parole.
Marketing
Verifica se i clienti stanno discutendo di una campagna promozionale, la loro reazione a un banner, ecc.
Filtraggio e automazione
Rilevamento di frasi chiave o indesiderate per il controllo mirato delle conversazioni, senza doverle ascoltare tutte.
Vantaggi del modulo Voice-to-Text
Nessuna attrezzatura speciale richiesta
Funziona su normali PC con quasi tutte le telecamere e schede video.
Massima flessibilità
Varie tipologie di reazione (incluse quelle programmabili dall'utente) e integrazione con sistemi di terze parti.
Elaborazione in tempo reale
Elaborazione dei flussi in tempo reale, senza latenza. Esecuzione sul proprio hardware locale.
Soluzione accessibile
Il modulo può essere acquistato in aggiunta alla licenza Standard o Pro.
Come funziona
Creazione della catena
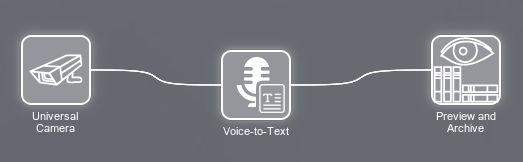
Poiché il modulo elabora un flusso audio, è necessaria una sorgente sonora nella catena.
- Sorgente sonora: microfono integrato nella telecamera oppure microfono USB o IP separato
- Esempio di catena: “Telecamera universale” – “Voice-to-Text” – “Anteprima e archivio”
- Il modulo richiede una licenza aggiuntiva rispetto a Xeoma Pro o Standard
Download risorse IA
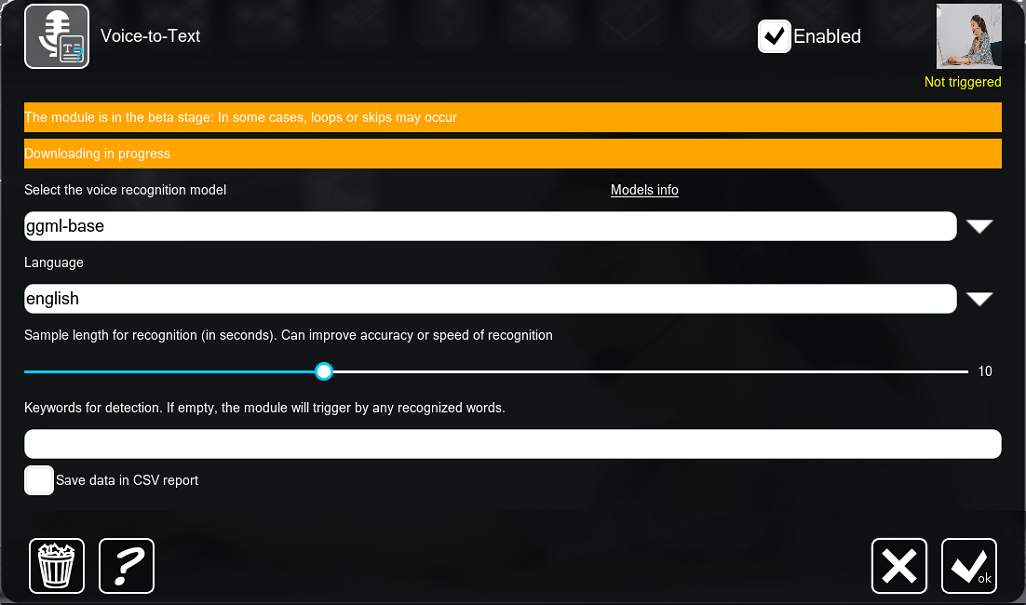
Clicca sull'icona Voice-to-Text nella catena per aprire le impostazioni del modulo. Il download delle risorse aggiuntive si avvierà automaticamente alla prima apertura delle impostazioni. Quando il messaggio “Download in corso” scompare, il sistema è pronto.
- Le risorse aggiuntive contengono dataset per l'intelligenza artificiale e vengono scaricate su richiesta dai server FelenaSoft
- Le risorse vengono scaricate solo quando necessario, mantenendo ridotte le dimensioni del programma
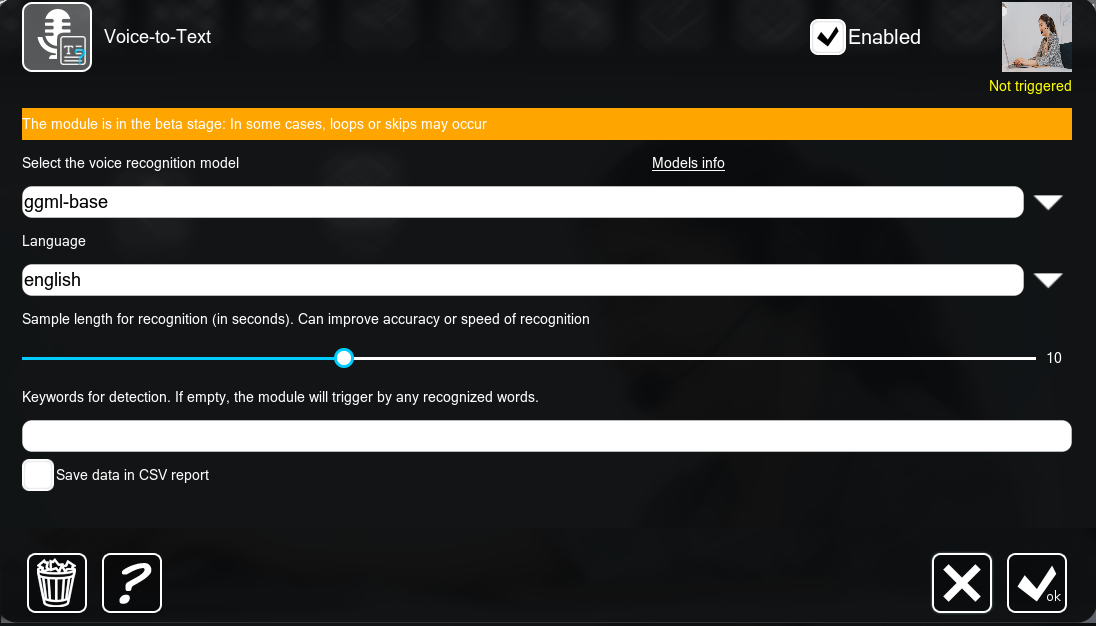
Scelta del modello di riconoscimento e delle parole chiave
Sono disponibili diversi modelli di IA per varie lingue, che differiscono per dimensioni, qualità del riconoscimento e carico sull'hardware. Nel campo "Modello di riconoscimento vocale", seleziona la lingua della trascrizione (non è necessario specificare la lingua del parlato) e, se necessario, inserisci le parole chiave per il rilevamento nel campo sottostante. Le opzioni "Visualizzazione del parlato riconosciuto durante la visione in tempo reale" e "Salva il parlato riconosciuto nei sottotitoli durante la registrazione/esportazione dell'archivio" consentono di sovrapporre la trascrizione al video live e nell'archivio.
- "Parole chiave per il rilevamento" — il modulo reagisce solo alle parole o frasi desiderate
- Sovrapposizione della trascrizione nell'anteprima live e nell'archivio
- "Salva dati in report CSV" — la trascrizione viene salvata in un file di foglio di calcolo sul disco
- Configura una reazione a valle del modulo: registrazione, notifica, invio di un comando
- La macro
%VOICE%è disponibile nei moduli "Invio richiesta HTTP", "Invio email" ed "Esecutore applicazioni"
Integrazione con programmi esterni
Voice-to-Text può essere utilizzato da programmi esterni, ad esempio per trascrivere conversazioni VoIP. Invia un file .mp3 al modulo e ottieni il risultato in formato testo, anche su postazioni operatore prive di Xeoma o telecamere. Importante: sono supportati solo i file .mp3.
Esempio di richiesta tramite Xeoma API (JSON):
curl -F "audio_file=@speech.mp3" "http://192.168.0.67:10090/api?login=Administrator&password=123&speech_recognition=recognition&model=qwen3-asr-1.7b&ttl=10&language=en"
Dove:
audio_file=@speech.mp3— il percorso del file audio sul computer192.168.0.67— l'indirizzo IP del server Xeoma10090— la porta del server XeomaAdministrator/123— login dell'Amministratore (sempre Administrator) e passwordmodel=…— il modello di riconoscimento (consultare l'elenco seguente)language=en— la lingua della trascrizione. Se differisce dalla lingua effettiva del parlato, la trascrizione verrà tradotta automaticamente nella lingua specificata
Per salvare il risultato come file di testo, aggiungere >savetext.txt dopo il comando, dove savetext.txt è il nome del file di testo.
Modelli di riconoscimento per l'API:
| Nome | Descrizione | Codice API |
|---|---|---|
| Russian basic | 140 MB | tone |
| Russian enhanced | punteggiatura, 215 MB | giga |
| English basic | 70 MB | zipformer |
| Multilingual basic | punteggiatura, 1 GB, 0,6 miliardi di parametri | qwen3-asr-0.6b |
| Multilingue avanzato | punteggiatura, 2,2 GB, 1,7 miliardi di parametri | qwen3-asr-1.7b |
| Gemma4 multilingue base | punteggiatura, 2,2 GB, 1,7 miliardi di parametri | gemma4-e2b |
| Gemma4 multilingue avanzato | punteggiatura, 7 GB, 12 miliardi di parametri | gemma4-12b |
Elenco dei codici lingua
en — Inglese, zh — Cinese, de — Tedesco, es — Spagnolo, ru — Russo, ko — Coreano, fr — Francese, ja — Giapponese, pt — Portoghese, tr — Turco, pl — Polacco, ca — Catalano, nl — Olandese, ar — Arabo, sv — Svedese, it — Italiano, id — Indonesiano, hi — Hindi, fi — Finlandese, vi — Vietnamita, he — Ebraico, uk — Ucraino, el — Greco, ms — Malese, cs — Ceco, ro — Rumeno, da — Danese, hu — Ungherese, ta — Tamil, no — Norvegese, th — Thailandese, ur — Urdu, hr — Croato, bg — Bulgaro, lt — Lituano, la — Latino, mi — Maori, ml — Malayalam, cy — Gallese, sk — Slovacco, te — Telugu, fa — Persiano, lv — Lettone, bn — Bengalese, sr — Serbo, az — Azero, sl — Sloveno, kn — Kannada, et — Estone, mk — Macedone, br — Bretone, eu — Basco, is — Islandese, hy — Armeno, ne — Nepalese, mn — Mongolo, bs — Bosniaco, kk — Kazako, sq — Albanese, sw — Swahili, gl — Galiziano, mr — Marathi, pa — Punjabi, si — Singalese, km — Khmer, sn — Shona, yo — Yoruba, so — Somalo, af — Afrikaans, oc — Occitano, ka — Georgiano, be — Bielorusso, tg — Tagico, sd — Sindhi, gu — Gujarati, am — Amarico, yi — Yiddish, lo — Lao, uz — Uzbeco, fo — Faroese, ht — Creolo haitiano, ps — Pashto, tk — Turkmeno, nn — Nynorsk, mt — Maltese, sa — Sanscrito, lb — Lussemburghese, my — Birmano, bo — Tibetano, tl — Tagalog, mg — Malgascio, as — Assamese, tt — Tataro, haw — Hawaiano, ln — Lingala, ha — Hausa, ba — Baschiro, jw — Giavanese, su — Sundanese, yue — Cantonese.
Come testare
Scarica e avvia Xeoma. Utilizza la versione di prova oppure attiva una licenza Xeoma Standard/Xeoma Pro insieme alla licenza del modulo aggiuntivo "Voice-to-Text".
Aggiungi una telecamera manualmente o attendi il rilevamento automatico da parte di Xeoma nella rete. Per un microfono esterno, collega il modulo "Microfono" e seleziona la sorgente audio appropriata.
Aggiungi il modulo "Voice-to-Text" alla catena, configura la reazione a parole chiave o la trascrizione continua del parlato e, se necessario, abilita la sovrapposizione della trascrizione sull'immagine della telecamera e nelle registrazioni.
Imposta una reazione all'evento: salvataggio in CSV, notifiche mobili o altro.
licenza demo gratuita
Altri moduli per l'elaborazione di flussi audio
Questi moduli operano autonomamente o in combinazione con Voice-to-Text.
Seleziona un microfono USB o un microfono IP separato come sorgente audio.
Analizza i flussi audio e si attiva quando il livello sonoro supera una soglia specifica.
Riconosce allarmi auto, pianti di bambini, spari, urla e vetri infranti.
Voice-to-Text: riconoscimento vocale in Xeoma
Prova Xeoma gratuitamente
Inserisci nome ed email per ricevere una licenza demo gratuita. Nessuna carta di credito richiesta.
Ricevi via email le licenze demo gratuite di Xeoma
Funzionalità complete. Invio istantaneo.
Ti invitiamo a non utilizzare indirizzi email contenenti dati personali e a non inviarci dati personali in alcun altro modo. Qualora lo facessi, inviando questo modulo confermi il tuo consenso al trattamento dei tuoi dati personali
Hai bisogno di altro?
Il modulo non soddisfa appieno le tue esigenze? Possiamo sviluppare le funzioni necessarie e integrarle in Xeoma come sviluppo personalizzato a pagamento. Dettagli.
Hai domande o ti serve supporto? Contattaci! Saremo lieti di aiutarti!
Pronti a iniziare?
Prova la Trascrizione vocale con una licenza demo gratuita: nessuna carta di credito o dato personale richiesto.