
वॉइस-टू-टेक्स्ट
स्पीच रिकग्निशन के लिए Xeoma का इंटेलिजेंट मॉड्यूल
 यह मॉड्यूल कैमरे या अलग माइक्रोफोन से आने वाली ऑडियो स्ट्रीम को 'सुनता' है, वाणी की पहचान करता है, कीवर्ड्स पर प्रतिक्रिया देता है और आपकी प्राथमिकताओं के अनुसार बातचीत के ट्रांसक्रिप्शन को CSV रिपोर्ट में सेव करता है या लाइव वीडियो/आर्काइव पर टेक्स्ट के रूप में ओवरले करता है। यह .mp3 फाइलों, जैसे बातचीत की रिकॉर्डिंग और ट्रेनिंग वीडियो आदि का भी ट्रांसक्रिप्शन कर सकता है।

महत्वपूर्ण: बीटा वर्ज़न
यह मॉड्यूल Xeoma 24.8.12 से उपलब्ध है और बीटा अवस्था में है, इसलिए कुछ मामलों में यह शब्दों को छोड़ सकता है या लूप्स दिखा सकता है। किसी विशेष उपकरण की आवश्यकता नहीं है: किसी भी कैमरे या माइक्रोफोन से साउंड स्ट्रीम और GPU वाला एक सामान्य कंप्यूटर पर्याप्त है।
एप्लिकेशन परिदृश्य
वॉयस-टू-टेक्स्ट निजी जीवन, शहर और नागरिकों की सुरक्षा के साथ-साथ व्यावसायिक क्षेत्र में सुरक्षा बेहतर बनाने में मदद करता है और व्यवसाय संचालन के अनुकूलन में योगदान देता है।
बुजुर्गों की देखभाल
मदद की पुकार पर तुरंत प्रतिक्रिया देने या उन्हें स्कैमर्स से बचाने की क्षमता।
कोई भी व्यवसाय
कस्टमर सर्विस गुणवत्ता का स्वचालित नियंत्रण (उदाहरण के लिए, अपशब्दों का पता लगाना)।
कॉल सेंटर
कंपनी पॉलिसी और कन्वर्सेशन स्क्रिप्ट के अनुपालन की निगरानी के लिए कॉल रिकॉर्डिंग का ट्रांसक्रिप्शन।
सिटी सर्विलांस
आतंकवाद विरोधी सुरक्षा और खतरे का संकेत देने वाले शब्दों की पहचान।
पैरेंटल कंट्रोल
बच्चे को बुलिंग से बचाने या स्कैमर्स से बातचीत को रोकने में सहायता।
पुलिस
बॉडी-वर्न कैमरों के अलावा — संदिग्ध के साथ बातचीत का ट्रांसक्रिप्शन और धमकियों का पता लगाना।
रिसर्च और एनालिटिक्स
स्पीच-संबंधित अध्ययनों और शब्दों के उपयोग की आवृत्ति के लिए बैकग्राउंड में आंकड़े एकत्र करना।
मार्केटिंग
यह पता लगाएं कि ग्राहक किसी प्रमोशनल कैंपेन के बारे में चर्चा कर रहे हैं या बैनर पर उनकी क्या प्रतिक्रिया है।
फिल्टरिंग और ऑटोमेशन
बातचीत के लक्षित नियंत्रण के लिए अवांछित या मुख्य वाक्यांशों का पता लगाना — बिना पूरी बातचीत सुने।
वॉयस-टू-टेक्स्ट मॉड्यूल के लाभ
किसी विशेष उपकरण की आवश्यकता नहीं
लगभग किसी भी कैमरे और ग्राफिक्स कार्ड वाले सामान्य कंप्यूटरों पर कार्य करता है।
पूरी तरह लचीला
विभिन्न प्रतिक्रियाएं (आपके अपने प्रोग्रामेबल विकल्पों सहित) और थर्ड-पार्टी सिस्टम के साथ इंटीग्रेशन।
रियल-टाइम प्रोसेसिंग
बिना किसी देरी के स्ट्रीम्स के साथ त्वरित प्रोसेसिंग। आपके अपने हार्डवेयर पर चलता है।
किफायती समाधान
इस मॉड्यूल को स्टैंडर्ड या प्रो लाइसेंस के अतिरिक्त खरीदा जा सकता है।
यह कैसे काम करता है
चेन बनाएं
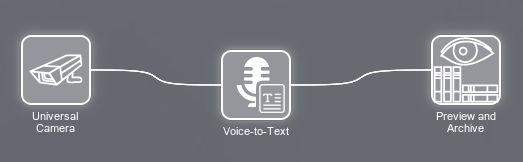
चूंकि मॉड्यूल ऑडियो स्ट्रीम के साथ काम करता है, इसलिए आपको चेन में एक साउंड सोर्स की आवश्यकता होगी।
- साउंड सोर्स: कैमरे में लगा माइक्रोफोन, या एक अलग USB या IP माइक्रोफोन
- सैंपल चेन: “यूनिवर्सल कैमरा” – “वॉयस-टू-टेक्स्ट” – “प्रीव्यू और आर्काइव”
- यह मॉड्यूल Xeoma प्रो या स्टैंडर्ड लाइसेंस के अतिरिक्त लाइसेंस किया जाता है
AI रिसोर्सेज डाउनलोड करें
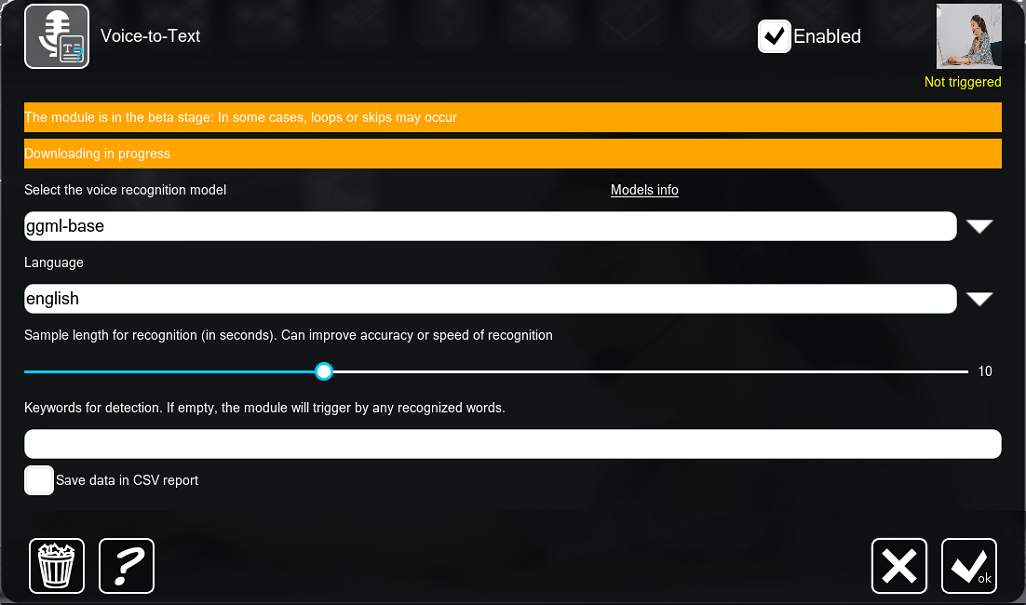
मॉड्यूल सेटिंग्स खोलने के लिए चेन में वॉयस-टू-टेक्स्ट आइकन पर क्लिक करें। पहली बार सेटिंग्स खोलने पर अतिरिक्त रिसोर्सेज का डाउनलोड स्वतः शुरू हो जाएगा। जब “डाउनलोडिंग इन प्रोग्रेस” संदेश गायब हो जाए, तो इसका अर्थ है कि सब कुछ तैयार है।
- अतिरिक्त रिसोर्सेज में आर्टिफिशियल इंटेलिजेंस के लिए डेटा एरे होते हैं और ये FelenaSoft सर्वर से अनुरोध पर डाउनलोड किए जाते हैं
- रिसोर्सेज केवल आवश्यकता होने पर ही डाउनलोड किए जाते हैं — इससे प्रोग्राम का आकार छोटा रहता है
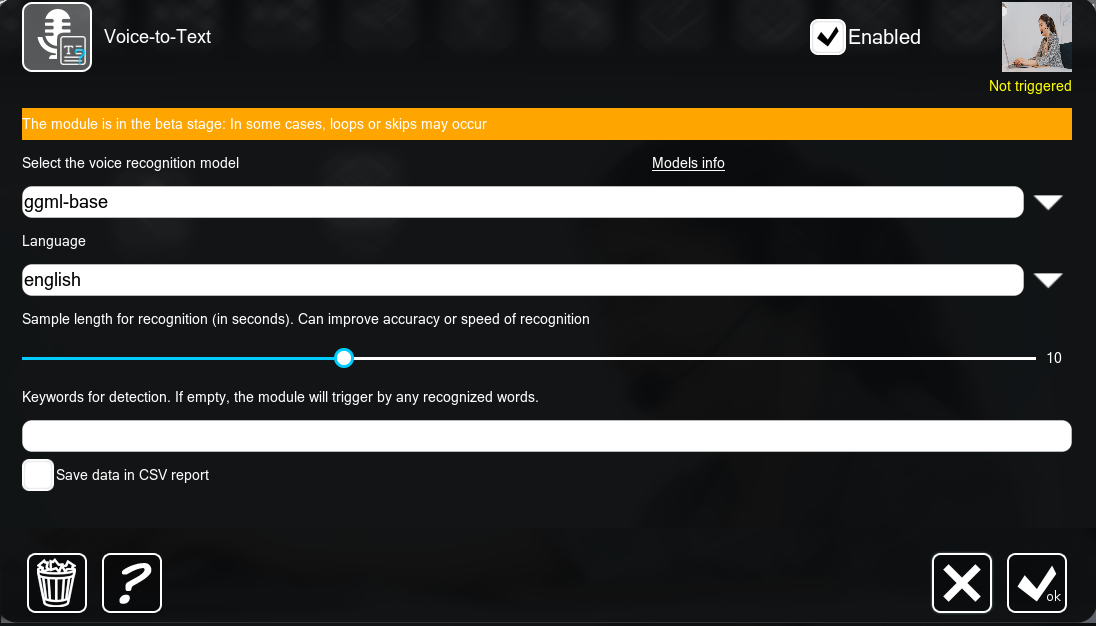
रिकग्निशन मॉडल और कीवर्ड्स चुनें
विभिन्न भाषाओं के लिए कई AI मॉडल उपलब्ध हैं, जो आकार, पहचान की गुणवत्ता और हार्डवेयर पर पड़ने वाले लोड के आधार पर भिन्न होते हैं। “Speech recognition model” फ़ील्ड में ट्रांसक्रिप्ट की भाषा चुनें (बोली जाने वाली भाषा निर्दिष्ट करने की आवश्यकता नहीं है) और यदि आवश्यक हो, तो नीचे दिए गए फ़ील्ड में डिटेक्शन के लिए कीवर्ड निर्दिष्ट करें। “Display of recognized speech during real-time viewing” और “Save recognized speech in subtitles when recording/exporting the archive” विकल्पों द्वारा आप लाइव वीडियो और आर्काइव दोनों में ट्रांसक्रिप्ट को ओवरले कर सकते हैं।
- “Keywords for detection” — मॉड्यूल केवल उन्हीं शब्दों या वाक्यांशों पर प्रतिक्रिया देगा जिन्हें आपने निर्दिष्ट किया है
- लाइव प्रीव्यू और आर्काइव में ट्रांसक्रिप्ट ओवरले
- “Save data in CSV report” — ट्रांसक्रिप्ट को डिस्क पर स्प्रेडशीट फ़ाइल में सहेजा जाता है
- मॉड्यूल के बाद प्रतिक्रिया कॉन्फ़िगर करें: रिकॉर्डिंग, सूचना, कमांड भेजना
%VOICE%मैक्रो “HTTP Request Sender”, “Email Sending” और “Application Runner” मॉड्यूल में उपलब्ध है
बाहरी प्रोग्रामों के साथ एकीकरण (Integration)
Voice-to-Text का उपयोग बाहरी प्रोग्राम से भी किया जा सकता है — उदाहरण के लिए, VoIP वार्तालापों को ट्रांसक्राइब करने हेतु। मॉड्यूल को .mp3 फ़ाइल प्रदान करें और टेक्स्ट के रूप में परिणाम प्राप्त करें — यह उन ऑपरेटर वर्कस्टेशन पर भी संभव है जहाँ Xeoma या कैमरे स्थापित नहीं हैं। महत्वपूर्ण: केवल .mp3 फ़ाइलें समर्थित हैं।
Xeoma API (JSON) के माध्यम से अनुरोध का उदाहरण:
curl -F "audio_file=@speech.mp3" "http://192.168.0.67:10090/api?login=Administrator&password=123&speech_recognition=recognition&model=qwen3-asr-1.7b&ttl=10&language=en"
जहाँ:
audio_file=@speech.mp3— आपके कंप्यूटर पर ऑडियो फ़ाइल का पथ192.168.0.67— Xeoma सर्वर का IP एड्रेस10090— Xeoma सर्वर पोर्टAdministrator/123— एडमिनिस्ट्रेटर लॉगिन (हमेशा Administrator) और पासवर्डmodel=…— पहचान मॉडल (नीचे दी गई सूची देखें)language=en— ट्रांसक्रिप्ट की भाषा। यदि यह बोली जाने वाली वास्तविक भाषा से भिन्न है, तो ट्रांसक्रिप्ट स्वचालित रूप से आपके द्वारा चयनित भाषा में अनुवादित हो जाएगी
परिणाम को टेक्स्ट फ़ाइल के रूप में सहेजने के लिए, कमांड के बाद >savetext.txt जोड़ें, जहाँ savetext.txt टेक्स्ट फ़ाइल का नाम है।
API के लिए रिकग्निशन मॉडल:
| नाम | विवरण | API कोड |
|---|---|---|
| Russian basic | 140 MB | tone |
| Russian enhanced | विराम चिह्न, 215 MB | giga |
| English basic | 70 MB | zipformer |
| Multilingual basic | विराम चिह्न, 1 GB, 0.6B पैरामीटर | qwen3-asr-0.6b |
| उन्नत बहुभाषी | विराम चिह्न, 2.2 GB, 1.7B पैरामीटर | qwen3-asr-1.7b |
| Gemma4 बहुभाषी बेसिक | विराम चिह्न, 2.2 GB, 1.7B पैरामीटर | gemma4-e2b |
| Gemma4 उन्नत बहुभाषी | विराम चिह्न, 7 GB, 12B पैरामीटर | gemma4-12b |
भाषा कोडों की सूची
en — अंग्रेज़ी, zh — चीनी, de — जर्मन, es — स्पेनिश, ru — रूसी, ko — कोरियाई, fr — फ्रेंच, ja — जापानी, pt — पुर्तगाली, tr — तुर्की, pl — पोलिश, ca — कैटलन, nl — डच, ar — अरबी, sv — स्वीडिश, it — इतालवी, id — इंडोनेशियाई, hi — हिंदी, fi — फिनिश, vi — वियतनामी, he — हिब्रू, uk — यूक्रेनियाई, el — ग्रीक, ms — मलय, cs — चेक, ro — रोमानियाई, da — डैनिश, hu — हंगेरियाई, ta — तमिल, no — नॉर्वेजियाई, th — थाई, ur — उर्दू, hr — क्रोएशियाई, bg — बल्गेरियाई, lt — लिथुआनियाई, la — लैटिन, mi — माओरी, ml — मलयालम, cy — वेल्श, sk — स्लोवाक, te — तेलुगु, fa — फ़ारसी, lv — लातवियाई, bn — बंगाली, sr — सर्बियाई, az — अज़रबैजानी, sl — स्लोवेनियाई, kn — कन्नड़, et — एस्टोनियाई, mk — मैसिडोनियाई, br — ब्रेटन, eu — बास्क, is — आइसलैंडिक, hy — अर्मेनियाई, ne — नेपाली, mn — मंगोलियाई, bs — बोस्नियाई, kk — कज़ाख, sq — अल्बानियाई, sw — स्वाहिली, gl — गैलिशियन, mr — मराठी, pa — पंजाबी, si — सिंहली, km — खमेर, sn — शोना, yo — योरूबा, so — सोमाली, af — अफ्रीकांस, oc — ओसीटान, ka — जॉर्जियाई, be — बेलारूसी, tg — ताजिक, sd — सिंधी, gu — गुजराती, am — अम्हारिक, yi — यिद्दिश, lo — लाओ, uz — उज़्बेक, fo — फरोइज़, ht — हैतियाई क्रियोल, ps — पश्तो, tk — तुर्कमेन, nn — नीनोर्स्क, mt — माल्टीज़, sa — संस्कृत, lb — लक्ज़मबर्गी, my — म्यांमार, bo — तिब्बती, tl — टैगलॉग, mg — मालागासी, as — असमिया, tt — तातार, haw — हवाईयन, ln — लिंगाला, ha — हौसा, ba — बशकिर, jw — जावानीज़, su — सुंडानीज़, yue — कैंटोनीज़
परीक्षण कैसे करें
Xeoma डाउनलोड करें और लॉन्च करें। ट्रायल संस्करण का उपयोग करें या Xeoma Standard/Xeoma Pro लाइसेंस + “Voice-to-text” अतिरिक्त मॉड्यूल लाइसेंस सक्रियेट करें।
कैमरा मैन्युअल रूप से जोड़ें या प्रतीक्षा करें जब तक कि Xeoma आपके नेटवर्क में कैमरों को स्वचालित रूप से न खोज ले। अलग माइक्रोफ़ोन के लिए, “Microphone” मॉड्यूल कनेक्ट करें और उपयुक्त ध्वनि स्रोत चुनें।
चेन में “Voice-to-Text” मॉड्यूल जोड़ें, कीवर्ड्स या निरंतर स्पीच ट्रांसक्रिप्शन के लिए प्रतिक्रिया सेट करें और, यदि आवश्यक हो, तो कैमरा इमेज और रिकॉर्डिंग पर ट्रांसक्रिप्ट ओवरले सक्षम करें।
ईवेंट के लिए प्रतिक्रिया सेट करें — CSV में सहेजना, मोबाइल नोटिफिकेशन या कोई अन्य।
डेमो लाइसेंस
ऑडियो स्ट्रीम को प्रोसेस करने वाले अन्य मॉड्यूल
ये मॉड्यूल स्वतंत्र रूप से या Voice-to-Text के साथ मिलकर काम करते हैं।
ध्वनि स्रोत के रूप में USB माइक्रोफ़ोन या अलग IP माइक्रोफ़ोन चुनें।
ऑडियो स्ट्रीम का विश्लेषण करता है और ध्वनि स्तर के निर्दिष्ट सीमा से अधिक होने पर ट्रिगर होता है।
कार अलार्म, बच्चे के रोने, गोली चलने, चीखने और कांच टूटने की पहचान करता है।
Voice-to-Text: Xeoma में स्पीच रिकग्निशन
Xeoma को मुफ़्त में आज़माएं
मुफ़्त डेमो लाइसेंस प्राप्त करने के लिए अपना नाम और ईमेल दर्ज करें। क्रेडिट कार्ड की आवश्यकता नहीं है।
ईमेल पर Xeoma मुफ़्त डेमो लाइसेंस प्राप्त करें
पूर्ण कार्यक्षमता। तुरंत भेजा जाएगा।
हम आपसे अनुरोध करते हैं कि ऐसे ईमेल का उपयोग न करें जिनमें व्यक्तिगत डेटा हो, और किसी अन्य तरीके से हमें व्यक्तिगत डेटा न भेजें। यदि आप फिर भी ऐसा करते हैं, तो इस फॉर्म को सबमिट करके, आप अपनी सहमति की पुष्टि करते हैं अपने व्यक्तिगत डेटा के प्रसंस्करण के लिए
क्या आपको कुछ और चाहिए?
क्या मॉड्यूल आपकी आवश्यकताओं के अनुकूल नहीं है? हम आपके लिए आवश्यक फंक्शन्स विकसित कर सकते हैं और उन्हें पेड डेवलपमेंट के रूप में Xeoma में जोड़ सकते हैं। विवरण देखें।
प्रश्न हैं? सहायता चाहिए? कृपया हमसे संपर्क करें! हमें आपकी मदद करने में खुशी होगी!
शुरू करने के लिए तैयार हैं?
मुफ़्त डेमो लाइसेंस के साथ वॉइस-टू-टेक्स्ट आज़माएं — क्रेडिट कार्ड या व्यक्तिगत डेटा की आवश्यकता नहीं।