
แปลงเสียงเป็นข้อความ
โมดูลอัจฉริยะของ Xeoma สำหรับการจดจำเสียงพูด
 โมดูลนี้ 'รับฟัง' สตรีมเสียงจากกล้องหรือไมโครโฟนแยกต่างหาก เพื่อรู้จำเสียงพูด ตอบสนองต่อคำสำคัญ และบันทึกบทถอดความการสนทนาในรายงาน CSV หรือแสดงข้อความซ้อนทับบนวิดีโอสด/คลังวิดีโอตามที่คุณกำหนด นอกจากนี้ยังสามารถถอดความไฟล์ .mp3 ได้ เช่น บันทึกการสนทนา วิดีโออบรม และอื่นๆ

ข้อควรทราบ: เวอร์ชันเบต้า
โมดูลนี้พร้อมใช้งานตั้งแต่ Xeoma 24.8.12 และอยู่ในสถานะเบต้า ดังนั้นในบางกรณีอาจข้ามคำหรือเกิดการวนซ้ำ ไม่จำเป็นต้องใช้อุปกรณ์พิเศษ: ใช้สตรีมเสียงจากกล้องหรือไมโครโฟนใดก็ได้ ร่วมกับคอมพิวเตอร์ทั่วไปที่มี GPU
รูปแบบการใช้งาน
ระบบแปลงเสียงเป็นข้อความช่วยยกระดับความปลอดภัยทั้งในชีวิตส่วนตัว ความปลอดภัยสาธารณะ และภาคธุรกิจ พร้อมทั้งเพิ่มประสิทธิภาพการดำเนินงาน
การดูแลผู้สูงอายุ
ความสามารถในการตอบสนองต่อเสียงร้องขอความช่วยเหลือได้ทันที หรือปกป้องพวกเขาจากมิจฉาชีพ
ทุกประเภทธุรกิจ
ควบคุมคุณภาพการบริการลูกค้าโดยอัตโนมัติ (เช่น ตรวจจับคำหยาบคาย)
ศูนย์บริการลูกค้า
ถอดความบันทึกการโทรเพื่อตรวจสอบการปฏิบัติตามนโยบายบริษัทและสคริปต์การสนทนา
การเฝ้าระวังเมือง
การรักษาความปลอดภัยต่อต้านการก่อการร้าย และการรู้จำคำที่บ่งบอกถึงภัยคุกคาม
การควบคุมโดยผู้ปกครอง
ช่วยปกป้องเด็กจากการถูกกลั่นแกล้งหรือการติดต่อกับมิจฉาชีพ
ตำรวจ
นอกเหนือจากกล้องติดตัวเจ้าหน้าที่ ยังสามารถถอดความการสนทนากับผู้ต้องสงสัยและตรวจจับภัยคุกคามได้
การวิจัยและการวิเคราะห์
รวบรวมข้อมูลสถิติพื้นฐานสำหรับการศึกษาด้านภาษาและความถี่ในการใช้คำ
การตลาด
ติดตามว่าลูกค้ากำลังพูดถึงแคมเปญโปรโมชันหรือมีปฏิกิริยาต่อป้ายโฆษณาอย่างไร
การกรองและระบบอัตโนมัติ
ตรวจจับวลีที่ไม่ต้องการหรือคำสำคัญเพื่อควบคุมการสนทนาแบบเจาะจง โดยไม่ต้องฟังการสนทนาทั้งหมด
จุดเด่นของโมดูลแปลงเสียงเป็นข้อความ
ไม่ต้องใช้อุปกรณ์พิเศษ
ทำงานได้บนคอมพิวเตอร์ทั่วไป รองรับกล้องและการ์ดจอเกือบทุกรุ่น
ยืดหยุ่นสูง
รองรับการตอบสนองหลากหลายรูปแบบ (รวมถึงการกำหนดค่าเอง) และผสานรวมกับระบบภายนอกได้
ทำงานแบบเรียลไทม์
ประมวลผลสตรีมได้ทันทีโดยไม่มีความหน่วง ทำงานบนฮาร์ดแวร์ของคุณเอง
โซลูชันที่คุ้มค่า
สามารถซื้อโมดูลนี้เพิ่มเติมจากไลเซนส์ Standard หรือ Pro ได้
หลักการทำงาน
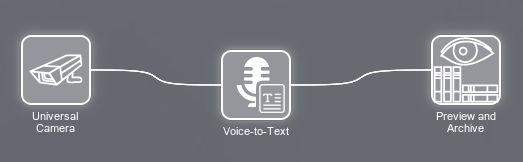
สร้างสายการทำงาน (Chain)
เนื่องจากโมดูลทำงานกับสตรีมเสียง คุณจึงต้องมีแหล่งกำเนิดเสียงในสายการทำงาน
- แหล่งกำเนิดเสียง: ไมโครโฟนในตัวกล้อง หรือไมโครโฟน USB หรือ IP แยกต่างหาก
- ตัวอย่างสายการทำงาน: “Universal Camera” – “Voice-to-Text” – “Preview and Archive”
- โมดูลนี้ต้องซื้อไลเซนส์เพิ่มเติม จากไลเซนส์ Xeoma Pro หรือ Standard
ดาวน์โหลดทรัพยากร AI
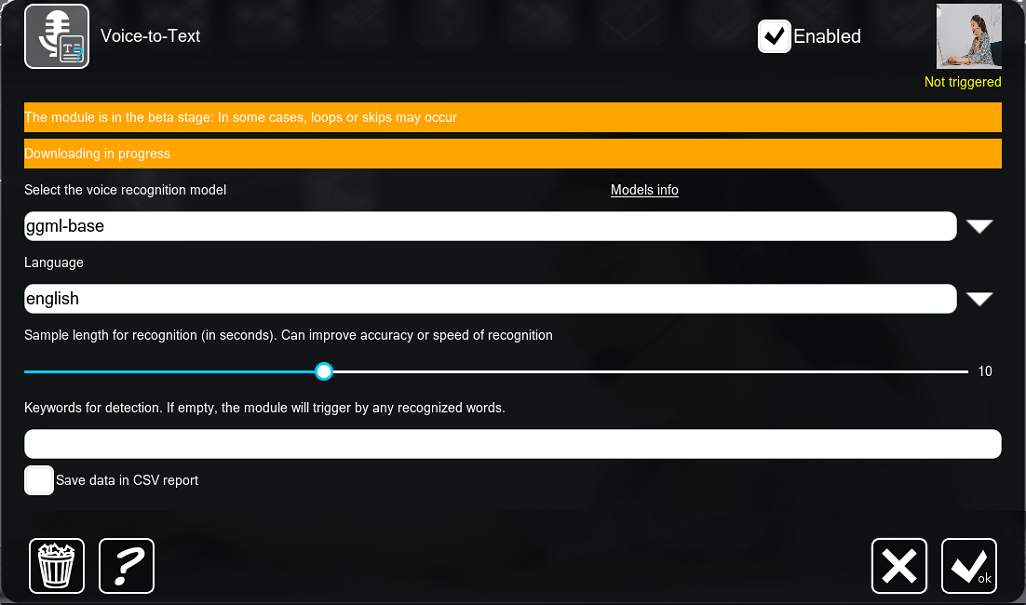
คลิกไอคอน Voice-to-Text ในเชนเพื่อเปิดการตั้งค่าโมดูล ระบบจะเริ่มดาวน์โหลดทรัพยากรเพิ่มเติมโดยอัตโนมัติเมื่อเปิดการตั้งค่าครั้งแรก เมื่อข้อความ “Downloading in progress” หายไป แสดงว่าพร้อมใช้งาน
- ทรัพยากรเพิ่มเติมประกอบด้วยชุดข้อมูลสำหรับ AI ซึ่งจะดาวน์โหลดตามคำขอจากเซิร์ฟเวอร์ FelenaSoft
- ดาวน์โหลดทรัพยากรเมื่อจำเป็นเท่านั้น เพื่อให้ขนาดโปรแกรมเล็กที่สุด
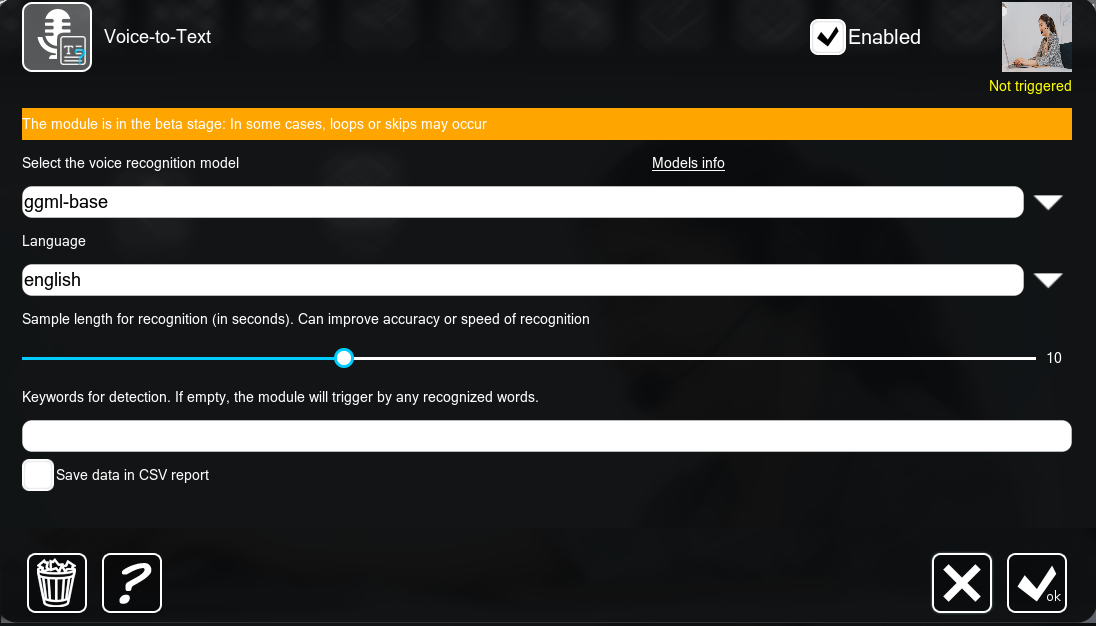
เลือกโมเดลการรู้จำเสียงพูดและคำสำคัญ
มีโมเดล AI ให้เลือกใช้หลายรุ่นตามภาษาที่แตกต่างกัน โดยมีความแตกต่างด้านขนาด คุณภาพการรู้จำ และภาระการทำงานของฮาร์ดแวร์ ในช่อง “Speech recognition model” ให้เลือกภาษาของบทถอดความ (ไม่จำเป็นต้องระบุภาษาของคำพูดจริง) และหากจำเป็น สามารถระบุคำสำคัญสำหรับการตรวจจับในช่องด้านล่างได้ สวิตช์ “Display of recognized speech during real-time viewing” และ “Save recognized speech in subtitles when recording/exporting the archive” ช่วยให้คุณแสดงบทถอดความซ้อนทับบนวิดีโอแบบเรียลไทม์และในไฟล์บันทึกย้อนหลังได้
- “Keywords for detection” — โมดูลจะตอบสนองเฉพาะคำหรือวลีที่คุณต้องการเท่านั้น
- แสดงบทถอดความซ้อนทับทั้งในตัวอย่างสดและไฟล์บันทึกย้อนหลัง
- “Save data in CSV report” — บันทึกบทถอดความลงในไฟล์สเปรดชีตบนดิสก์
- กำหนดการตอบสนองหลังการทำงานของโมดูล: บันทึก, แจ้งเตือน, ส่งคำสั่ง
- มาโคร
%VOICE%สามารถใช้งานได้ในโมดูล “HTTP Request Sender”, “Email Sending” และ “Application Runner”
การรวมระบบกับโปรแกรมภายนอก
Voice-to-Text ใช้งานผ่านโปรแกรมภายนอกได้ เช่น การถอดความการสนทนา VoIP เพียงส่งไฟล์ .mp3 ไปยังโมดูลเพื่อรับผลลัพธ์เป็นข้อความ แม้บนเวิร์กสเตชันของผู้ปฏิบัติงานที่ไม่มี Xeoma หรือกล้องติดตั้งอยู่ก็ตาม สำคัญ: รองรับเฉพาะไฟล์ .mp3 เท่านั้น
ตัวอย่างการส่งคำขอผ่าน Xeoma API (JSON):
curl -F "audio_file=@speech.mp3" "http://192.168.0.67:10090/api?login=Administrator&password=123&speech_recognition=recognition&model=qwen3-asr-1.7b&ttl=10&language=en"
คำอธิบาย:
audio_file=@speech.mp3— เส้นทางไปยังไฟล์เสียงในคอมพิวเตอร์ของคุณ192.168.0.67— ที่อยู่ IP ของเซิร์ฟเวอร์ Xeoma10090— พอร์ตของเซิร์ฟเวอร์ XeomaAdministrator/123— ชื่อผู้ใช้ Administrator (ต้องเป็น Administrator เสมอ) และรหัสผ่านmodel=…— โมเดลการรู้จำ (ดูรายการด้านล่าง)language=en— ภาษาของบทถอดความ หากแตกต่างจากภาษาที่พูดจริง บทถอดความจะถูกแปลเป็นภาษาที่คุณระบุโดยอัตโนมัติ
หากต้องการบันทึกผลลัพธ์เป็นไฟล์ข้อความ ให้เพิ่ม >savetext.txt ต่อท้ายคำสั่ง โดยที่ savetext.txt คือชื่อไฟล์ข้อความ
โมเดลการรู้จำสำหรับ API:
| ชื่อ | คำอธิบาย | รหัส API |
|---|---|---|
| Russian basic | 140 MB | tone |
| Russian enhanced | รวมเครื่องหมายวรรคตอน, 215 MB | giga |
| English basic | 70 MB | zipformer |
| Multilingual basic | เครื่องหมายวรรคตอน, 1 GB, 0.6 พันล้านพารามิเตอร์ | qwen3-asr-0.6b |
| รองรับหลายภาษา (รุ่นปรับปรุง) | เครื่องหมายวรรคตอน, 2.2 GB, 1.7 พันล้านพารามิเตอร์ | qwen3-asr-1.7b |
| Gemma4 รองรับหลายภาษา (รุ่นพื้นฐาน) | เครื่องหมายวรรคตอน, 2.2 GB, 1.7 พันล้านพารามิเตอร์ | gemma4-e2b |
| Gemma4 รองรับหลายภาษา (รุ่นปรับปรุง) | เครื่องหมายวรรคตอน, 7 GB, 12 พันล้านพารามิเตอร์ | gemma4-12b |
รายการรหัสภาษา
en — อังกฤษ, zh — จีน, de — เยอรมัน, es — สเปน, ru — รัสเซีย, ko — เกาหลี, fr — ฝรั่งเศส, ja — ญี่ปุ่น, pt — โปรตุเกส, tr — ตุรกี, pl — โปแลนด์, ca — กาตาลา, nl — ดัตช์, ar — อาหรับ, sv — สวีเดน, it — อิตาลี, id — อินโดนีเซีย, hi — ฮินดี, fi — ฟินแลนด์, vi — เวียดนาม, he — ฮีบรู, uk — ยูเครน, el — กรีก, ms — มลายู, cs — เช็ก, ro — โรมาเนีย, da — เดนมาร์ก, hu — ฮังการี, ta — ทมิฬ, no — นอร์เวย์, th — ไทย, ur — อูรดู, hr — โครเอเชีย, bg — บัลแกเรีย, lt — ลิทัวเนีย, la — ละติน, mi — เมารี, ml — มาลายาลัม, cy — เวลส์, sk — สโลวัก, te — เตลูกู, fa — เปอร์เซีย, lv — ลัตเวีย, bn — เบงกาลี, sr — เซอร์เบีย, az — อาเซอร์ไบจาน, sl — สโลวีเนีย, kn — กันนาดา, et — เอสโตเนีย, mk — มาซิโดเนีย, br — เบรอตง, eu — บาสก์, is — ไอซ์แลนด์, hy — อาร์เมเนีย, ne — เนปาล, mn — มองโกเลีย, bs — บอสเนีย, kk — คาซัคสถาน, sq — แอลเบเนีย, sw — สวาฮีลี, gl — กาลิเซีย, mr — มราฐี, pa — ปัญจาบ, si — สิงหล, km — เขมร, sn — โชนา, yo — โยรูบา, so — โซมาลี, af — แอฟริกานส์, oc — อ็อกซิตัน, ka — จอร์เจีย, be — เบลารุส, tg — ทาจิก, sd — สินธี, gu — คุชราต, am — อัมฮารา, yi — ยิดดิช, lo — ลาว, uz — อุซเบก, fo — แฟโร, ht — ครีโอลเฮติ, ps — พัชโต, tk — เติร์กเมน, nn — นือนอชก์, mt — มอลตา, sa — สันสกฤต, lb — ลักเซมเบิร์ก, my — พม่า, bo — ทิเบต, tl — ตากาล็อก, mg — มาลากาซี, as — อัสสัม, tt — ตาตาร์, haw — ฮาวาย, ln — ลิงกาลา, ha — เฮาซา, ba — บัชคีร์, jw — ชวา, su — ซุนดา, yue — กวางตุ้ง
วิธีการทดสอบ
ดาวน์โหลด และเปิดใช้งาน Xeoma ใช้ เวอร์ชันทดลอง หรือเปิดใช้งานไลเซนส์ Xeoma Standard/Xeoma Pro พร้อมไลเซนส์โมดูลเสริม “Voice-to-text”
เพิ่มกล้องด้วยตนเองหรือรอให้ Xeoma ค้นหากล้องในเครือข่ายของคุณโดยอัตโนมัติ หากใช้ไมโครโฟนแยกต่างหาก ให้เชื่อมต่อโมดูล “Microphone” แล้วเลือกแหล่งเสียงที่ต้องการ
เพิ่มโมดูล “Voice-to-Text” ลงในเชน ตั้งค่าการตอบสนองต่อคำสำคัญหรือการถอดความเสียงแบบต่อเนื่อง และหากจำเป็น สามารถเปิดใช้งานการแสดงข้อความทับบนภาพจากกล้องและวิดีโอบันทึกได้
ตั้งค่าการตอบสนองต่อเหตุการณ์ เช่น บันทึกเป็น CSV, แจ้งเตือนผ่านมือถือ หรืออื่นๆ
ไลเซนส์เดโม
โมดูลอื่นๆ ที่ประมวลผลสตรีมเสียง
โมดูลเหล่านี้ทำงานแยกอิสระหรือทำงานร่วมกับ Voice-to-Text
เลือกไมโครโฟน USB หรือไมโครโฟน IP แยกต่างหากเป็นแหล่งกำเนิดเสียง
วิเคราะห์สตรีมเสียงและแจ้งเตือนเมื่อระดับเสียงเกินขีดจำกัดที่กำหนด
จดจำเสียงสัญญาณกันขโมยรถ เสียงเด็กร้องไห้ เสียงปืน เสียงกรีดร้อง และเสียงกระจกแตก
Voice-to-Text: การจดจำเสียงพูดใน Xeoma
ทดลองใช้ Xeoma ฟรี
กรอกชื่อและอีเมลของคุณเพื่อรับไลเซนส์เดโมฟรี ไม่ต้องใช้บัตรเครดิต
รับไลเซนส์เดโมฟรีของ Xeoma ทางอีเมล
ใช้งานได้เต็มรูปแบบ ส่งให้ทันที
กรุณาหลีกเลี่ยงการใช้อีเมลที่มีข้อมูลส่วนบุคคล หรือส่งข้อมูลส่วนบุคคลผ่านช่องทางอื่น หากท่านยังคงดำเนินการดังกล่าว การส่งแบบฟอร์มนี้ถือว่า ท่านยืนยันความยินยอม ในการประมวลผลข้อมูลส่วนบุคคลของท่าน
ต้องการข้อมูลด้านอื่นเพิ่มเติมหรือไม่?
โมดูลปัจจุบันยังไม่ตอบโจทย์การใช้งานของคุณ? เราสามารถพัฒนาฟังก์ชันที่คุณต้องการและเพิ่มเข้าไปใน Xeoma ในฐานะบริการพัฒนาซอฟต์แวร์แบบชำระเงิน ดูรายละเอียด
มีคำถามหรือต้องการความช่วยเหลือ? ติดต่อเราได้เลย! เรายินดีให้บริการ
พร้อมเริ่มต้นใช้งานหรือยัง?
ทดสอบการแปลงเสียงเป็นข้อความด้วยใบอนุญาตทดลองใช้ฟรี — ไม่ต้องใช้บัตรเครดิตหรือข้อมูลส่วนตัว