
 이 모듈은 카메라 또는 별도 마이크의 오디오 스트림을 '청취'하여 음성을 인식하고 키워드에 반응합니다. 설정에 따라 대화 내용을 CSV 리포트로 저장하거나 라이브 영상 및 아카이브에 텍스트로 오버레이할 수 있습니다. 또한 대화 녹음, 교육 영상 등 .mp3 파일의 텍스트 변환도 지원합니다.

중요: 베타 버전
본 모듈은 제오마 Xeoma 24.8.12 버전부터 제공되는 베타 버전으로, 경우에 따라 단어 누락이나 반복 오류가 발생할 수 있습니다. 별도의 전용 장비는 필요하지 않으며, 카메라나 마이크의 오디오 스트림과 GPU가 탑재된 일반 PC만으로 충분히 사용할 수 있습니다.
적용 시나리오
음성-텍스트 변환 기능은 개인 및 공공 안전을 강화하고 상업 분야에서의 보안 수준을 높이며, 비즈니스 운영 최적화에도 기여합니다.
노인 케어
긴급 구조 요청에 즉각 대응하거나 보이스피싱 등의 사기 범죄로부터 보호할 수 있습니다.
모든 비즈니스
고객 서비스 품질 자동 관리 (예: 비속어 탐지)
콜센터
통화 녹음 텍스트 변환을 통한 사내 규정 및 상담 스크립트 준수 여부 모니터링
도시 감시
대테러 보안 강화 및 위험 키워드 인식
자녀 보호
학교 폭력 예방 및 사기꾼 접촉 차단 지원
경찰
바디캠과 연동하여 용의자와의 대화 내용을 텍스트로 변환하고 위협 요소를 탐지합니다.
연구 및 분석
음성 관련 연구 및 어휘 사용 빈도 분석을 위한 백그라운드 통계 수집
마케팅
고객의 프로모션 캠페인 언급 여부, 배너 광고 반응 등 파악
필터링 및 자동화
모든 대화를 직접 청취하지 않고도 특정 문구 또는 핵심 키워드 탐지를 통해 대화를 선별적으로 모니터링할 수 있습니다.
음성-텍스트 변환 모듈의 주요 강점
특수 장비 불필요
거의 모든 카메라 및 그래픽 카드가 장착된 일반 PC에서 작동합니다.
뛰어난 유연성
사용자 지정 프로그래밍 가능한 반응을 포함한 다양한 동작 설정 및 타사 시스템 연동 지원
실시간 처리
지연 없이 스트림을 실시간 처리하며, 자체 하드웨어에서 구동됩니다.
경제적인 솔루션
Standard 또는 Pro 라이선스에 추가하여 구매할 수 있습니다.
작동 방식
체인 구성
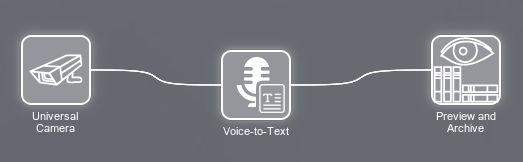
본 모듈은 오디오 스트림을 처리하므로 체인에 사운드 소스가 포함되어야 합니다.
- 사운드 소스: 카메라 내장 마이크 또는 별도 USB/IP 마이크
- 체인 예시: “범용 카메라” – “음성-텍스트 변환” – “미리보기 및 아카이브”
- 본 모듈은 제오마 Xeoma Pro 또는 Standard 라이선스에 추가로 적용되는 라이선스입니다
AI 리소스 다운로드
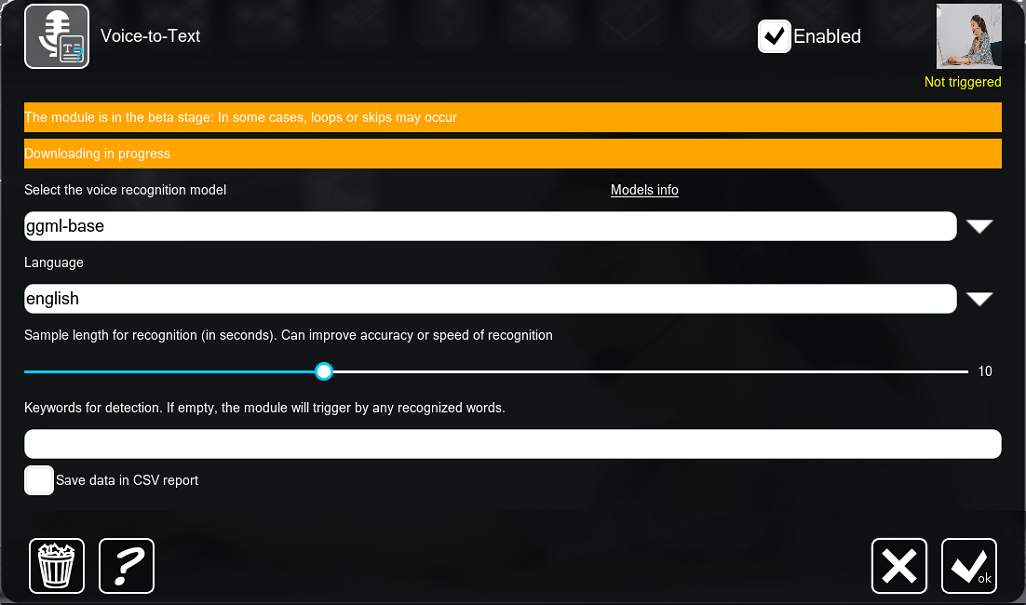
체인에서 음성-텍스트 변환 아이콘을 클릭하면 모듈 설정 창이 열립니다. 설정 창을 처음 열면 추가 리소스 다운로드가 자동으로 시작되며, "다운로드 진행 중" 메시지가 사라지면 준비가 완료됩니다.
- 추가 리소스에는 인공지능(AI) 데이터 세트가 포함되어 있으며, 페레나소프트 Felenasoft 서버에서 요청 시에만 다운로드됩니다
- 리소스는 필요할 때만 다운로드되므로 프로그램 용량을 최소화할 수 있습니다
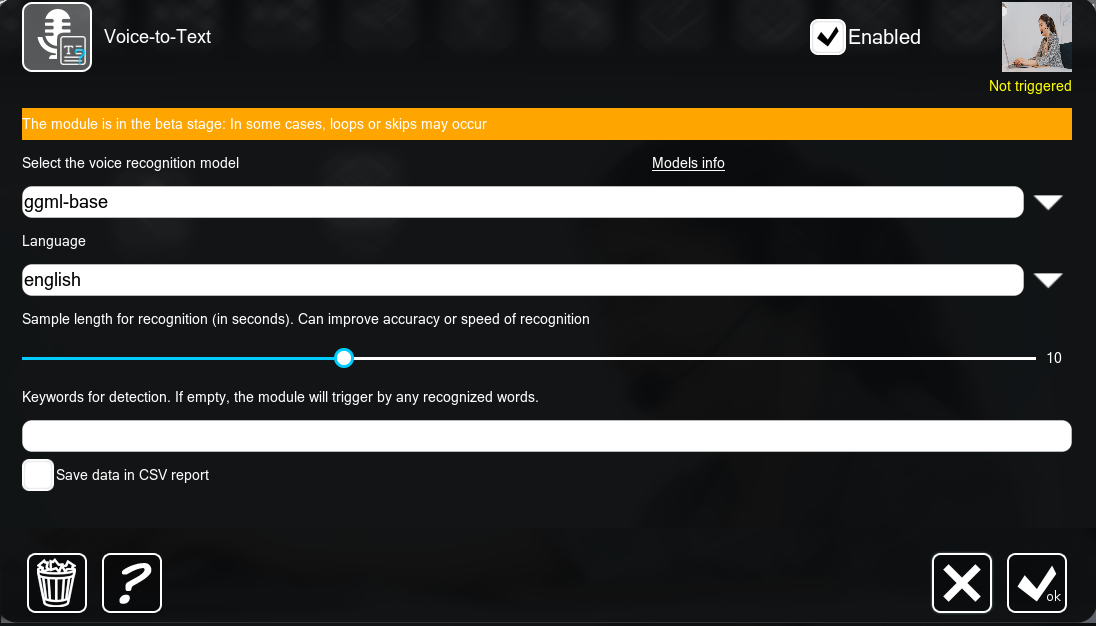
인식 모델 및 키워드 선택
다양한 언어를 지원하는 여러 인공지능(AI) 모델이 제공되며, 모델별로 크기, 인식 정확도 및 하드웨어 부하 수준이 상이합니다. “음성 인식 모델” 필드에서 전사 언어를 선택하고(실제 음성 언어는 별도 지정 불필요), 필요시 아래 필드에 탐지할 키워드를 입력하십시오. “실시간 보기 중 인식된 음성 표시” 및 “녹화/아카이브 내보내기 시 인식된 음성을 자막으로 저장” 스위치를 활성화하면 라이브 영상과 아카이브에 전사 텍스트를 오버레이할 수 있습니다.
- “탐지 키워드” — 모듈이 지정한 단어나 문구에만 반응하도록 설정합니다
- 라이브 미리보기 및 아카이브의 전사 텍스트 오버레이
- “CSV 보고서에 데이터 저장” — 전사 내용을 디스크의 스프레드시트 파일로 저장합니다
- 모듈 후속 동작 연결: 녹화, 알림, 명령 전송
%VOICE%매크로는 “HTTP 요청 전송”, “이메일 전송” 및 “애플리케이션 실행” 모듈에서 사용할 수 있습니다
외부 프로그램 연동
Voice-to-Text는 외부 프로그램에서도 활용 가능합니다. 예를 들어 VoIP 통화 내용을 전사할 때 .mp3 파일을 모듈에 전달하면, 제오마 Xeoma나 카메라가 없는 상담원 워크스테이션에서도 텍스트 결과를 얻을 수 있습니다. 중요: .mp3 파일만 지원됩니다.
제오마 Xeoma API(JSON) 요청 예시:
curl -F "audio_file=@speech.mp3" "http://192.168.0.67:10090/api?login=Administrator&password=123&speech_recognition=recognition&model=qwen3-asr-1.7b&ttl=10&language=en"
구성 요소 설명:
audio_file=@speech.mp3— 컴퓨터 내 오디오 파일 경로192.168.0.67— 제오마 Xeoma 서버 IP 주소10090— 제오마 Xeoma 서버 포트Administrator/123— 관리자 로그인 아이디(항상 Administrator) 및 비밀번호model=…— 인식 모델 (아래 목록 참조)language=en— 전사 결과 언어입니다. 실제 음성 언어와 다를 경우, 전사 결과가 지정한 언어로 자동 번역됩니다
결과를 텍스트 파일로 저장하려면 명령어 뒤에 >savetext.txt를 추가하십시오. 여기서 savetext.txt는 저장될 텍스트 파일 이름입니다.
API용 인식 모델:
| 이름 | 설명 | API 코드 |
|---|---|---|
| 러시아어 기본 | 140 MB | tone |
| 러시아어 확장 | 문장 부호 포함, 215 MB | giga |
| 영어 기본 | 70 MB | zipformer |
| 다국어 기본 | 구두점, 1 GB, 0.6B 파라미터 | qwen3-asr-0.6b |
| 다국어 지원 강화 모델 | 구두점, 2.2 GB, 1.7B 파라미터 | qwen3-asr-1.7b |
| Gemma4 다국어 기본 모델 | 구두점, 2.2 GB, 1.7B 파라미터 | gemma4-e2b |
| Gemma4 다국어 강화 모델 | 구두점, 7 GB, 12B 파라미터 | gemma4-12b |
언어 코드 목록
en — 영어, zh — 중국어, de — 독일어, es — 스페인어, ru — 러시아어, ko — 한국어, fr — 프랑스어, ja — 일본어, pt — 포르투갈어, tr — 튀르키예어, pl — 폴란드어, ca — 카탈루냐어, nl — 네덜란드어, ar — 아랍어, sv — 스웨덴어, it — 이탈리아어, id — 인도네시아어, hi — 힌디어, fi — 핀란드어, vi — 베트남어, he — 히브리어, uk — 우크라이나어, el — 그리스어, ms — 말레이어, cs — 체코어, ro — 루마니아어, da — 덴마크어, hu — 헝가리어, ta — 타밀어, no — 노르웨이어, th — 태국어, ur — 우르두어, hr — 크로아티아어, bg — 불가리아어, lt — 리투아니아어, la — 라틴어, mi — 마오리어, ml — 말라얄람어, cy — 웨일스어, sk — 슬로바키아어, te — 텔루구어, fa — 페르시아어, lv — 라트비아어, bn — 벵골어, sr — 세르비아어, az — 아제르바이잔어, sl — 슬로베니아어, kn — 칸나다어, et — 에스토니아어, mk — 마케도니아어, br — 브르타뉴어, eu — 바스크어, is — 아이슬란드어, hy — 아르메니아어, ne — 네팔어, mn — 몽골어, bs — 보스니아어, kk — 카자흐어, sq — 알바니아어, sw — 스와힐리어, gl — 갈리시아어, mr — 마라티어, pa — 펀잡어, si — 싱할라어, km — 크메르어, sn — 쇼나어, yo — 요루바어, so — 소말리어, af — 아프리칸스어, oc — 오크어, ka — 조지아어, be — 벨라루스어, tg — 타지크어, sd — 신디어, gu — 구자라트어, am — 암하라어, yi — 이디시어, lo — 라오어, uz — 우즈베크어, fo — 페로어, ht — 아이티 크레올어, ps — 파슈토어, tk — 투르크멘어, nn — 뉘노르스크어, mt — 몰타어, sa — 산스크리트어, lb — 룩셈부르크어, my — 미얀마어, bo — 티베트어, tl — 타갈로그어, mg — 말라가시어, as — 아삼어, tt — 타타르어, haw — 하와이어, ln — 링갈라어, ha — 하우사어, ba — 바시키르어, jw — 자바어, su — 순다어, yue — 광둥어.
테스트 방법
카메라를 수동으로 추가하거나 제오마가 네트워크에서 카메라를 자동으로 찾을 때까지 기다리십시오. 별도 마이크를 사용하려면 'Microphone' 모듈을 연결하고 적절한 오디오 소스를 선택하십시오.
체인에 'Voice-to-Text' 모듈을 추가하고 키워드 또는 연속 음성 전사에 대한 반응을 설정하십시오. 필요한 경우 카메라 영상 및 녹화본에 전사 텍스트 오버레이를 활성화할 수 있습니다.
이벤트 발생 시 반응을 설정하십시오. CSV 저장, 모바일 알림 전송 등 다양한 옵션을 선택할 수 있습니다.
데모 라이선스 받기
오디오 스트림을 처리하는 기타 모듈
이 모듈들은 단독으로 또는 Voice-to-Text와 연동하여 작동합니다.
Voice-to-Text: 제오마의 음성 인식 기능
제오마 무료 체험하기
이름과 이메일을 입력하여 무료 데모 라이선스를 받으십시오. 신용카드 정보는 필요하지 않습니다.
이메일로 제오마 무료 데모 라이선스 받기
모든 기능 제공. 즉시 전송됩니다.
개인정보가 포함된 이메일 사용이나 기타 방식으로 개인정보를 전송하지 마시기 바랍니다. 그럼에도 정보를 제출하시는 경우, 본 양식 제출을 통해 귀하의 개인정보 처리에 동의한 것으로 간주됩니다