
Voice-to-Text
Modul cerdas Xeoma untuk pengenalan ucapan
 Modul ini 'mendengarkan' stream audio dari kamera atau mikrofon terpisah, mengenali ucapan, merespons kata kunci, dan menyimpan transkrip percakapan dalam laporan CSV atau menampilkannya sebagai teks pada video live/arsip sesuai preferensi Anda. Modul ini juga dapat mentranskripsi file .mp3: rekaman percakapan, video pelatihan, dll.

Penting: versi beta
Modul ini tersedia mulai Xeoma 24.8.12 dan masih dalam tahap beta, sehingga dalam beberapa kasus mungkin melewatkan kata atau mengalami pengulangan. Tidak diperlukan peralatan khusus: stream suara dari kamera atau mikrofon apa pun serta komputer standar dengan GPU sudah memadai.
Skenario aplikasi
Voice-to-Text meningkatkan keamanan dalam kehidupan pribadi, kehidupan kota dan warga, serta di sektor komersial, dan mengoptimalkan operasional bisnis.
Perawatan lansia
Kemampuan untuk bereaksi instan terhadap teriakan minta tolong atau melindungi mereka dari penipu.
Segala jenis bisnis
Kontrol otomatis kualitas layanan pelanggan (misalnya, deteksi kata-kata kasar).
Call center
Transkripsi rekaman panggilan untuk memantau kepatuhan terhadap kebijakan perusahaan dan skrip percakapan.
Pengawasan kota
Keamanan anti-terorisme dan pengenalan kata-kata yang mengindikasikan bahaya.
Kontrol orang tua
Membantu melindungi anak dari perundungan atau komunikasi dengan penipu.
Polisi
Selain kamera yang dikenakan di tubuh — transkripsi percakapan dengan tersangka dan deteksi ancaman.
Riset dan analitik
Pengumpulan statistik latar belakang untuk studi terkait ucapan dan frekuensi penggunaan kata.
Pemasaran
Mengetahui apakah pelanggan membahas kampanye promosi, reaksi mereka terhadap banner, dan sebagainya.
Filtrasi dan otomatisasi
Deteksi frasa yang tidak diinginkan atau kata kunci untuk kontrol percakapan tertarget — tanpa harus mendengarkan seluruhnya.
Keunggulan modul Voice-to-Text
Tidak perlu peralatan khusus
Berjalan di komputer standar dengan hampir semua jenis kamera dan kartu grafis.
Sangat fleksibel
Berbagai respons (termasuk yang dapat diprogram sendiri) dan integrasi dengan sistem pihak ketiga.
Operasi real-time
Memproses stream secara real-time tanpa latensi. Berjalan di perangkat keras Anda sendiri.
Solusi terjangkau
Modul dapat dibeli sebagai tambahan lisensi Standard atau Pro.
Cara kerja
Buat rangkaian
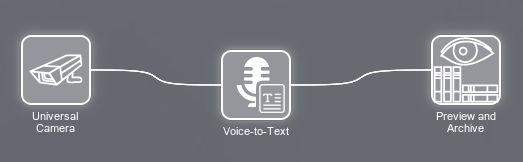
Karena modul ini memproses stream audio, Anda memerlukan sumber suara dalam rangkaian.
- Sumber suara: mikrofon bawaan kamera, atau mikrofon USB maupun IP terpisah
- Contoh rangkaian: “Universal Camera” – “Voice-to-Text” – “Preview and Archive”
- Modul ini dilisensikan secara terpisah dari lisensi Xeoma Pro atau Standard
Unduh sumber daya AI
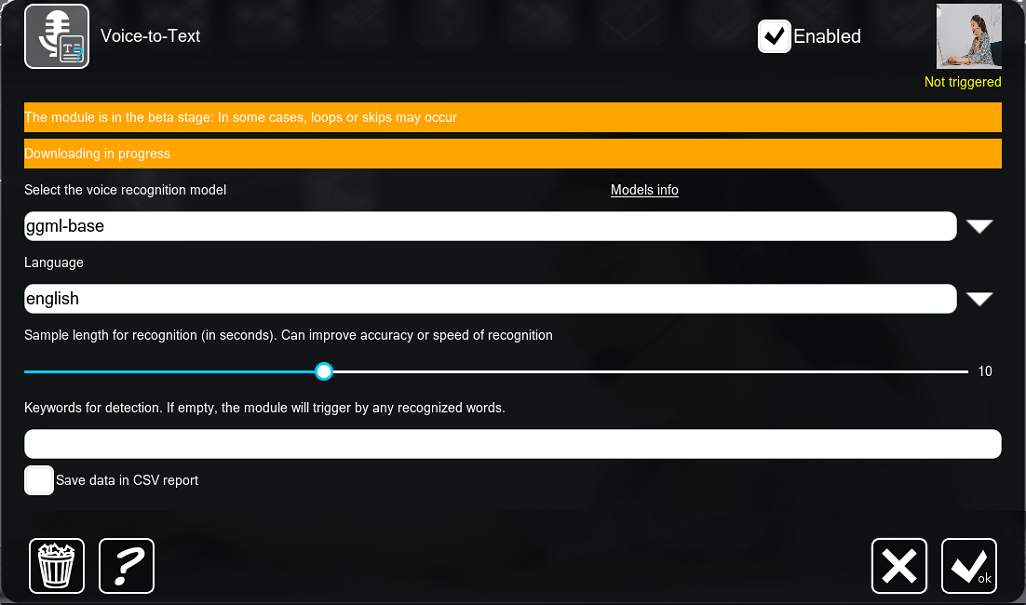
Klik ikon Voice-to-Text dalam rangkaian untuk membuka pengaturan modul. Pengunduhan sumber daya tambahan akan dimulai secara otomatis saat pertama kali Anda membuka pengaturan. Ketika pesan “Downloading in progress” hilang, berarti semuanya siap.
- Sumber daya tambahan berisi kumpulan data untuk kecerdasan buatan dan diunduh sesuai permintaan dari server FelenaSoft
- Sumber daya hanya diunduh saat dibutuhkan — sehingga ukuran program tetap kecil
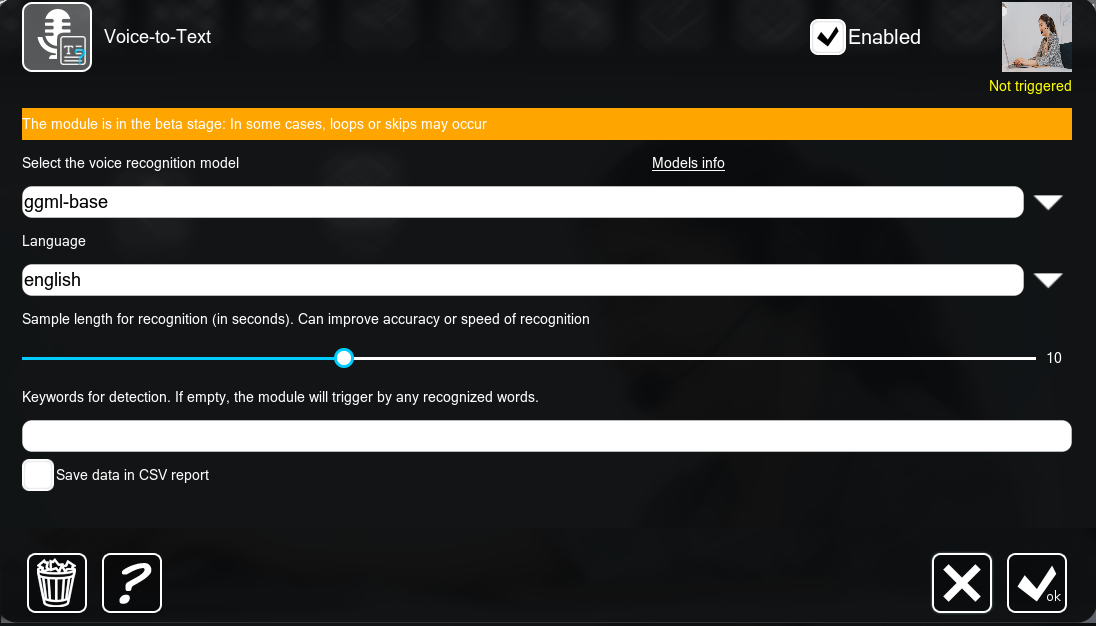
Pilih model pengenalan dan kata kunci
Tersedia beberapa model AI untuk berbagai bahasa dengan ukuran, kualitas pengenalan, dan beban perangkat keras yang berbeda. Pada kolom “Model pengenalan ucapan”, pilih bahasa transkrip (bahasa ucapan asli tidak perlu ditentukan) dan, jika diperlukan, tentukan kata kunci untuk deteksi di kolom bawahnya. Opsi “Tampilkan ucapan yang dikenali saat pratinjau langsung” dan “Simpan ucapan yang dikenali dalam subtitle saat merekam/mengekspor arsip” memungkinkan Anda menampilkan transkrip pada video langsung maupun di dalam arsip.
- “Kata kunci untuk deteksi” — modul hanya merespons kata atau frasa yang Anda tentukan
- Overlay transkrip pada pratinjau langsung dan arsip
- “Simpan data dalam laporan CSV” — transkrip disimpan sebagai file spreadsheet di disk
- Konfigurasikan respons setelah modul: perekaman, notifikasi, pengiriman perintah
- Makro
%VOICE%tersedia di modul “Pengirim Permintaan HTTP”, “Pengiriman Email”, dan “Penjalan Aplikasi”
Integrasi dengan program eksternal
Voice-to-Text dapat digunakan dari program eksternal — misalnya, untuk mentranskripsi percakapan VoIP. Kirimkan file .mp3 ke modul dan dapatkan hasilnya dalam bentuk teks — bahkan di workstation operator yang tidak memiliki Xeoma atau kamera. Penting: hanya file .mp3 yang didukung.
Contoh permintaan melalui Xeoma API (JSON):
curl -F "audio_file=@speech.mp3" "http://192.168.0.67:10090/api?login=Administrator&password=123&speech_recognition=recognition&model=qwen3-asr-1.7b&ttl=10&language=en"
Keterangan:
audio_file=@speech.mp3— jalur ke file audio di komputer Anda192.168.0.67— alamat IP server Xeoma10090— port server XeomaAdministrator/123— login Administrator (selalu Administrator) dan kata sandimodel=…— model pengenalan (lihat daftar di bawah)language=en— bahasa transkrip. Jika berbeda dari bahasa ucapan asli, transkrip akan diterjemahkan secara otomatis ke bahasa yang Anda tentukan
Untuk menyimpan hasil sebagai file teks, tambahkan >savetext.txt setelah perintah, dengan savetext.txt sebagai nama file teks.
Model pengenalan untuk API:
| Nama | Deskripsi | Kode API |
|---|---|---|
| Russian basic | 140 MB | tone |
| Russian enhanced | tanda baca, 215 MB | giga |
| English basic | 70 MB | zipformer |
| Multilingual basic | tanda baca, 1 GB, 0,6 miliar parameter | qwen3-asr-0.6b |
| Gemma4 multibahasa tingkat lanjut | tanda baca, 2,2 GB, 1,7 miliar parameter | qwen3-asr-1.7b |
| Gemma4 multibahasa dasar | tanda baca, 2,2 GB, 1,7 miliar parameter | gemma4-e2b |
| Gemma4 multibahasa tingkat lanjut | tanda baca, 7 GB, 12 miliar parameter | gemma4-12b |
Daftar kode bahasa
en — Inggris, zh — Mandarin, de — Jerman, es — Spanyol, ru — Rusia, ko — Korea, fr — Prancis, ja — Jepang, pt — Portugis, tr — Turki, pl — Polandia, ca — Katalan, nl — Belanda, ar — Arab, sv — Swedia, it — Italia, id — Indonesia, hi — Hindi, fi — Finlandia, vi — Vietnam, he — Ibrani, uk — Ukraina, el — Yunani, ms — Melayu, cs — Ceko, ro — Rumania, da — Denmark, hu — Hungaria, ta — Tamil, no — Norwegia, th — Thai, ur — Urdu, hr — Kroasia, bg — Bulgaria, lt — Lituania, la — Latin, mi — Maori, ml — Malayalam, cy — Wales, sk — Slovakia, te — Telugu, fa — Persia, lv — Latvia, bn — Bengali, sr — Serbia, az — Azerbaijan, sl — Slovenia, kn — Kannada, et — Estonia, mk — Makedonia, br — Breton, eu — Basque, is — Islandia, hy — Armenia, ne — Nepal, mn — Mongolia, bs — Bosnia, kk — Kazakh, sq — Albania, sw — Swahili, gl — Galisia, mr — Marathi, pa — Punjab, si — Sinhala, km — Khmer, sn — Shona, yo — Yoruba, so — Somali, af — Afrikaans, oc — Oksitan, ka — Georgia, be — Belarusia, tg — Tajik, sd — Sindhi, gu — Gujarat, am — Amharik, yi — Yiddish, lo — Laos, uz — Uzbek, fo — Faroe, ht — Kreol Haiti, ps — Pashto, tk — Turkmen, nn — Nynorsk, mt — Malta, sa — Sanskerta, lb — Luksemburg, my — Myanmar, bo — Tibet, tl — Tagalog, mg — Malagasi, as — Assam, tt — Tatar, haw — Hawaii, ln — Lingala, ha — Hausa, ba — Bashkir, jw — Jawa, su — Sunda, yue — Kanton
Cara menguji
Unduh dan jalankan Xeoma. Gunakan edisi Uji Coba atau aktifkan lisensi Xeoma Standard/Xeoma Pro + lisensi modul tambahan “Voice-to-text”.
Tambahkan kamera secara manual atau tunggu hingga Xeoma menemukan kamera di jaringan Anda secara otomatis. Untuk mikrofon eksternal, tambahkan modul “Microphone” dan pilih sumber suara yang sesuai.
Tambahkan modul “Voice-to-Text” ke dalam rantai, konfigurasikan respons terhadap kata kunci atau transkripsi ucapan berkelanjutan, dan jika perlu, aktifkan overlay transkrip pada tampilan kamera serta rekaman.
Konfigurasikan respons terhadap peristiwa — simpan ke CSV, notifikasi seluler, atau tindakan lainnya.
lisensi demo
Modul lain untuk pemrosesan aliran audio
Modul-modul ini dapat beroperasi secara mandiri maupun terintegrasi dengan Voice-to-Text.
Pilih mikrofon USB atau mikrofon IP terpisah sebagai sumber suara.
Menganalisis aliran audio dan memicu peringatan saat level suara melampaui batas yang ditetapkan.
Mengenali alarm mobil, tangisan anak, tembakan senjata api, teriakan, dan kaca pecah.
Voice-to-Text: Pengenalan Ucapan di Xeoma
Coba Xeoma gratis
Masukkan nama dan email Anda untuk mendapatkan lisensi demo gratis. Tanpa kartu kredit.
Kirim lisensi demo gratis Xeoma ke email
Fitur lengkap. Terkirim seketika.
Kami mengimbau Anda untuk tidak menggunakan alamat email yang mengandung data pribadi, atau mengirimkan data pribadi kepada kami melalui cara lain. Jika Anda tetap melakukannya, dengan mengirimkan formulir ini, Anda menyatakan persetujuan atas pemrosesan data pribadi Anda
Apakah Anda membutuhkan hal lain?
Modul belum sepenuhnya sesuai dengan kebutuhan Anda? Kami dapat mengembangkan fungsi khusus dan menambahkannya ke dalam Xeoma sebagai pengembangan berbayar. Lihat detailnya.
Ada pertanyaan? Butuh bantuan? Hubungi kami! Tim kami siap membantu!
Siap memulai?
Uji Suara-ke-Teks dengan lisensi demo gratis — tanpa kartu kredit dan data pribadi.