
Перетворення мовлення на текст
Інтелектуальний модуль Xeoma для розпізнавання мовлення
 Модуль «слухає» аудіопотік із камери або окремого мікрофона, розпізнає мовлення, реагує на ключові слова та зберігає транскрипцію розмов у CSV-звіті або накладає її як текст на живе відео чи архів, залежно від налаштувань. Він також може транскрибувати .mp3-файли: записи розмов, навчальні відео тощо.

Важливо: бета-версія
Модуль доступний починаючи з Xeoma 24.8.12 і перебуває в стані бета-тестування, тому в окремих випадках може пропускати слова або створювати повтори. Спеціальне обладнання не потрібне: підходить аудіопотік з будь-якої камери чи мікрофона та звичайний ПК із GPU.
Сценарії використання
Перетворення мовлення на текст підвищує безпеку в приватному житті, міському просторі та комерційній сфері, а також оптимізує бізнес-процеси.
Догляд за літніми людьми
Можливість миттєво відреагувати на крик про допомогу або захистити від шахраїв.
Будь-який бізнес
Автоматизований контроль якості обслуговування клієнтів (наприклад, виявлення ненормативної лексики).
Колл-центр
Транскрипція записів дзвінків для контролю дотримання корпоративної політики та скриптів розмов.
Міське відеоспостереження
Антитерористична безпека та розпізнавання слів, що сигналізують про небезпеку.
Батьківський контроль
Захист дитини від булінгу або спілкування з шахраями.
Поліція
На додаток до натільних камер — транскрипція розмов із підозрюваним та виявлення погроз.
Дослідження та аналітика
Фоновий збір статистики для мовних досліджень та аналізу частотності слів.
Маркетинг
Визначення того, чи обговорюють клієнти рекламну кампанію, їхня реакція на банер тощо.
Фільтрація та автоматизація
Виявлення небажаних або ключових фраз для точкового контролю розмов без необхідності прослуховувати їх повністю.
Переваги модуля «Перетворення мовлення на текст»
Без спеціального обладнання
Працює на звичайних комп'ютерах майже з будь-якою камерою та відеокартою.
Повна гнучкість
Різноманітні реакції (зокрема власні програмовані) та інтеграція зі сторонніми системами.
Робота в реальному часі
Миттєва обробка потоків без затримок. Працює на власному обладнанні.
Доступне рішення
Модуль можна придбати додатково до ліцензії Standard або Pro.
Як це працює
Побудова ланцюжка
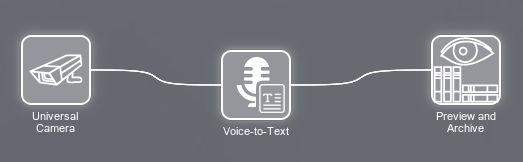
Оскільки модуль працює з аудіопотоком, у ланцюжку має бути джерело звуку.
- Джерело звуку: мікрофон, вбудований у камеру, або окремий USB- чи IP-мікрофон
- Приклад ланцюжка: «Universal Camera» – «Voice-to-Text» – «Preview and Archive»
- Модуль ліцензується додатково до ліцензії Xeoma Pro або Standard
Завантаження ресурсів ШІ
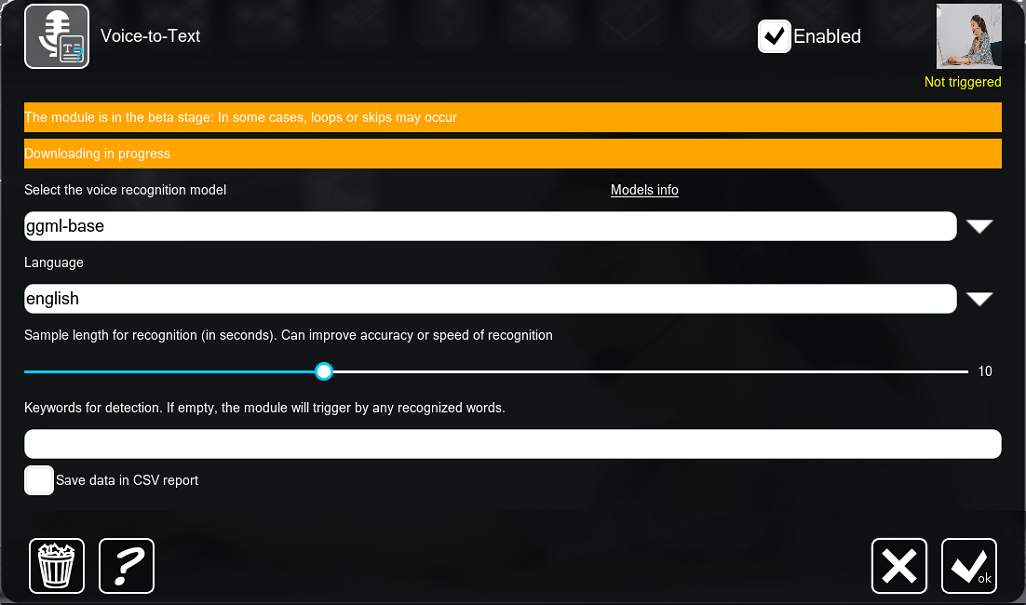
Натисніть на піктограму Voice-to-Text у ланцюжку, щоб відкрити налаштування модуля. Завантаження додаткових ресурсів розпочнеться автоматично при першому відкритті. Коли повідомлення «Downloading in progress» зникне, система готова до роботи.
- Додаткові ресурси містять масиви даних для штучного інтелекту та завантажуються на запит із серверів FelenaSoft
- Ресурси завантажуються лише за потреби, що забезпечує компактний розмір програми
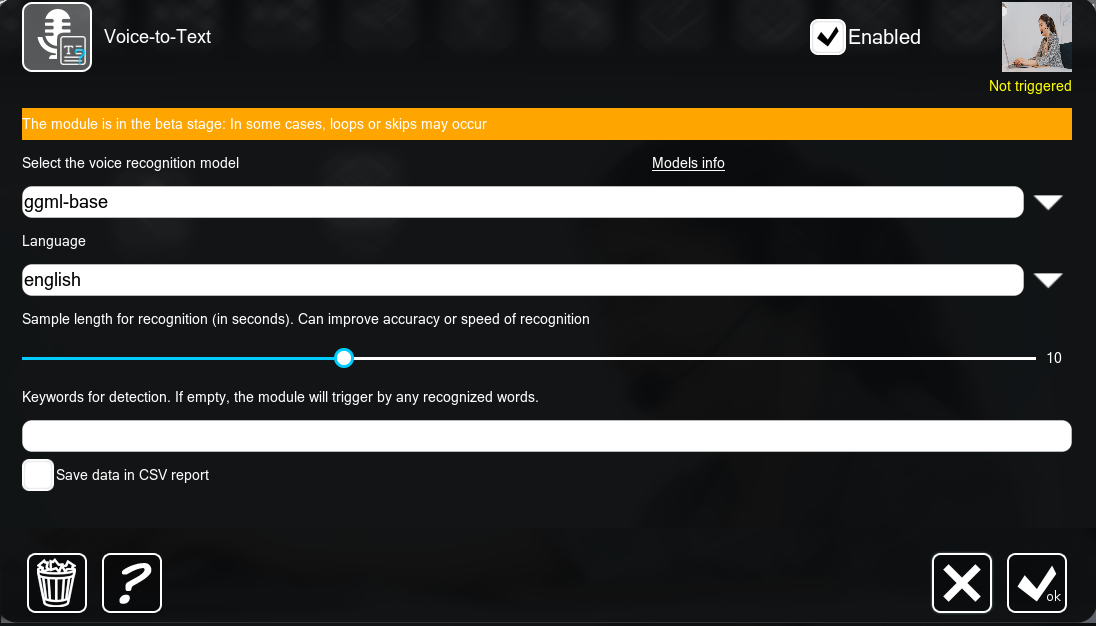
Вибір моделі розпізнавання та ключових слів
Доступно кілька ШІ-моделей для різних мов, що відрізняються розміром, якістю розпізнавання та навантаженням на обладнання. У полі «Модель розпізнавання мовлення» виберіть мову транскрибації (мову самого мовлення вказувати не потрібно) і, за потреби, задайте ключові слова для детекції в полі нижче. Перемикачі «Відображення розпізнаного мовлення під час перегляду в реальному часі» та «Збереження розпізнаного мовлення в субтитрах під час запису/експорту архіву» дають змогу накладати текст транскрибації на живе відео та в архіві.
- «Ключові слова для детекції» — модуль реагує лише на потрібні вам слова або фрази
- Накладання транскрибації в режимі реального часу та в архіві
- «Зберігати дані в CSV-звіті» — транскрибація зберігається у файлі таблиці на диску
- Налаштуйте реакцію після модуля: запис, сповіщення чи надсилання команди
- Макрос
%VOICE%доступний у модулях «Надсилання HTTP-запиту», «Надсилання електронної пошти» та «Запуск програми»
Інтеграція з зовнішніми програмами
Voice-to-Text можна використовувати із зовнішніх програм — наприклад, для транскрибації VoIP-розмов. Передайте модулю файл .mp3 та отримайте результат у вигляді тексту — навіть на робочих станціях операторів, де не встановлено Xeoma чи камери. Важливо: підтримуються лише файли .mp3.
Приклад запиту через Xeoma API (JSON):
curl -F "audio_file=@speech.mp3" "http://192.168.0.67:10090/api?login=Administrator&password=123&speech_recognition=recognition&model=qwen3-asr-1.7b&ttl=10&language=en"
Де:
audio_file=@speech.mp3— шлях до аудіофайлу на комп'ютері192.168.0.67— IP-адреса сервера Xeoma10090— порт сервера XeomaAdministrator/123— логін адміністратора (завжди Administrator) та парольmodel=…— модель розпізнавання (див. список нижче)language=en— мова транскрибації. Якщо вона відрізняється від фактичної мови мовлення, транскрибацію буде автоматично перекладено обраною вами мовою
Щоб зберегти результат у текстовому файлі, додайте >savetext.txt після команди, де savetext.txt — назва текстового файлу.
Моделі розпізнавання для API:
| Назва | Опис | Код API |
|---|---|---|
| Russian basic | 140 МБ | tone |
| Russian enhanced | пунктуація, 215 МБ | giga |
| English basic | 70 МБ | zipformer |
| Multilingual basic | пунктуація, 1 ГБ, 0,6 млрд параметрів | qwen3-asr-0.6b |
| Покращена багатомовна | пунктуація, 2,2 ГБ, 1,7 млрд параметрів | qwen3-asr-1.7b |
| Gemma4 базова багатомовна | пунктуація, 2,2 ГБ, 1,7 млрд параметрів | gemma4-e2b |
| Gemma4 покращена багатомовна | пунктуація, 7 ГБ, 12 млрд параметрів | gemma4-12b |
Список мовних кодів
en — англійська, zh — китайська, de — німецька, es — іспанська, ru — російська, ko — корейська, fr — французька, ja — японська, pt — португальська, tr — турецька, pl — польська, ca — каталонська, nl — нідерландська, ar — арабська, sv — шведська, it — італійська, id — індонезійська, hi — гінді, fi — фінська, vi — в'єтнамська, he — іврит, uk — українська, el — грецька, ms — малайська, cs — чеська, ro — румунська, da — данська, hu — угорська, ta — тамільська, no — норвезька, th — тайська, ur — урду, hr — хорватська, bg — болгарська, lt — литовська, la — латинська, mi — маорі, ml — малаялам, cy — валлійська, sk — словацька, te — телугу, fa — перська, lv — латвійська, bn — бенгальська, sr — сербська, az — азербайджанська, sl — словенська, kn — каннада, et — естонська, mk — македонська, br — бретонська, eu — баскська, is — ісландська, hy — вірменська, ne — непальська, mn — монгольська, bs — боснійська, kk — казахська, sq — албанська, sw — суахілі, gl — галісійська, mr — маратхі, pa — панджабі, si — сингальська, km — кхмерська, sn — шона, yo — йоруба, so — сомалійська, af — африкаанс, oc — окситанська, ka — грузинська, be — білоруська, tg — таджицька, sd — сіндхі, gu — гуджараті, am — амхарська, yi — їдиш, lo — лаоська, uz — узбецька, fo — фарерська, ht — гаїтянська креольська, ps — пушту, tk — туркменська, nn — нюношк, mt — мальтійська, sa — санскрит, lb — люксембурзька, my — бірманська, bo — тибетська, tl — тагальська, mg — малагасійська, as — ассамська, tt — татарська, haw — гавайська, ln — лінгала, ha — хауса, ba — башкирська, jw — яванська, su — сунданська, yue — кантонська.
Як протестувати
Завантажте та запустіть Xeoma. Скористайтеся пробною версією або активуйте ліцензію Xeoma Standard/Xeoma Pro разом із ліцензією на додатковий модуль «Voice-to-text».
Додайте камеру вручну або зачекайте, доки Xeoma автоматично знайде камери у вашій мережі. Для окремого мікрофона підключіть модуль «Microphone» та виберіть відповідне джерело звуку.
Додайте модуль «Voice-to-Text» до ланцюжка, налаштуйте реакцію на ключові слова або безперервну транскрибацію мовлення та, за потреби, увімкніть накладання тексту на зображення з камери й відеозаписи.
Налаштуйте реакцію на подію: збереження в CSV, мобільні сповіщення тощо.
демо-ліцензію
Інші модулі обробки аудіопотоків
Ці модулі працюють самостійно або разом із Voice-to-Text.
Виберіть USB-мікрофон або окремий IP-мікрофон як джерело звуку.
Аналізує аудіопотоки та спрацьовує, коли рівень звуку перевищує встановлений поріг.
Розпізнає автомобільну сигналізацію, плач дитини, постріли, крики, розбиття скла.
Voice-to-Text: розпізнавання мовлення в Xeoma
Спробуйте Xeoma безкоштовно
Введіть ім’я та електронну адресу, щоб отримати безкоштовну демо-ліцензію. Кредитна картка не потрібна.
Надіслати безкоштовні демо-ліцензії Xeoma на електронну пошту
Повний функціонал. Миттєве надсилання.
Просимо не використовувати електронні адреси, що містять персональні дані, та не надсилати нам персональні дані в інший спосіб. Якщо ви все ж таки це зробите, надсилаючи цю форму, ви підтверджуєте свою згоду на обробку ваших персональних даних
Потрібно щось інше?
Модуль не цілком відповідає вашим умовам? Ми можемо розробити потрібні вам функції та додати їх у Xeoma як платну розробку. Деталі.
Маєте запитання? Потрібна допомога? Зв’яжіться з нами! Будемо раді допомогти!
Готові розпочати?
Протестуйте модуль «Перетворення мовлення на текст» із безкоштовною демо-ліцензією — без банківської картки та персональних даних.