Voice-to-Text
Intelektwal na module ng Xeoma para sa speech recognition
 'Nakikinig' ang module sa audio stream mula sa camera o hiwalay na mikropono, kinikilala ang pananalita, tumutugon sa mga keyword, at sine-save ang transcript ng mga pag-uusap sa CSV report o inilalapat ito bilang text sa live video/archive depende sa iyong preference. Maaari rin itong mag-transcribe ng mga .mp3 file: mga recording ng pag-uusap, training video, atbp.

Mahalaga: beta version
Available ang module simula sa Xeoma 24.8.12 at nasa beta state pa, kaya sa ilang kaso ay maaaring may malaktawang salita o magkaroon ng loop. Hindi kailangan ng espesyal na kagamitan: sapat na ang sound stream mula sa anumang camera o mikropono at isang regular na computer na may GPU.
Mga scenario ng aplikasyon
Pinapahusay ng Voice-to-Text ang seguridad sa personal na buhay, sa lungsod at mga mamamayan, pati na rin sa komersyal na sektor, at nakatutulong sa pag-optimize ng mga operasyon ng negosyo.
Pag-aalaga sa mga nakatatanda
Kakayahang tumugon agad sa panawagan ng saklolo o protektahan sila mula sa mga scammer.
Anumang negosyo
Automated na kontrol sa kalidad ng customer service (halimbawa, pag-detect ng mga bastos na salita).
Call center
Transcription ng mga call recording upang i-monitor ang pagsunod sa policy ng kumpanya at mga conversation script.
Surveillance sa lungsod
Seguridad laban sa terorismo at recognition ng mga salitang nagbabanta ng panganib.
Parental control
Tulong sa pagprotekta sa bata laban sa bullying o pakikipag-usap sa mga scammer.
Pulisya
Bukod sa mga body-worn camera — transcription ng mga pag-uusap sa suspek at detection ng mga banta.
Pananaliksik at analytics
Pagkalap ng statistics sa background para sa mga pag-aaral ukol sa pananalita at dalas ng paggamit ng salita.
Marketing
Alamin kung tinatalakay ng mga customer ang isang promotional campaign, ang kanilang reaksyon sa banner, atbp.
Filtering at automation
Detection ng mga hindi gustong phrase o key phrase para sa targeted na kontrol ng mga pag-uusap — nang hindi na kailangang pakinggan ang lahat ng ito.
Mga bentahe ng Voice-to-Text module
Hindi kailangan ng espesyal na kagamitan
Gumagana sa mga regular na computer gamit ang halos anumang camera at graphics card.
Simple at flexible
Iba't ibang reaksyon (kabilang ang sarili mong programmable na reaksyon) at integration sa mga third-party system.
Real-time na pagproseso
On-the-fly na pagproseso ng mga stream, nang walang latency. Gumagana sa sarili mong hardware.
Abot-kayang solusyon
Maaaring bilhin ang module bilang dagdag sa Standard o Pro license.
Paano ito gumagana
Bumuo ng chain
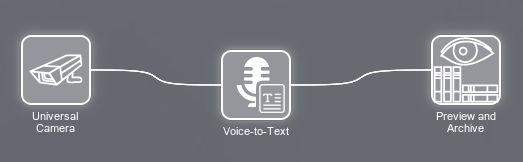
Dahil gumagana ang module sa audio stream, kailangan mo ng sound source sa chain.
- Sound source: built-in na mikropono sa camera, o hiwalay na USB o IP microphone
- Sample chain: “Universal Camera” – “Voice-to-Text” – “Preview and Archive”
- Ang module ay may lisensyang karagdagan sa Xeoma Pro o Standard license
I-download ang mga AI resource
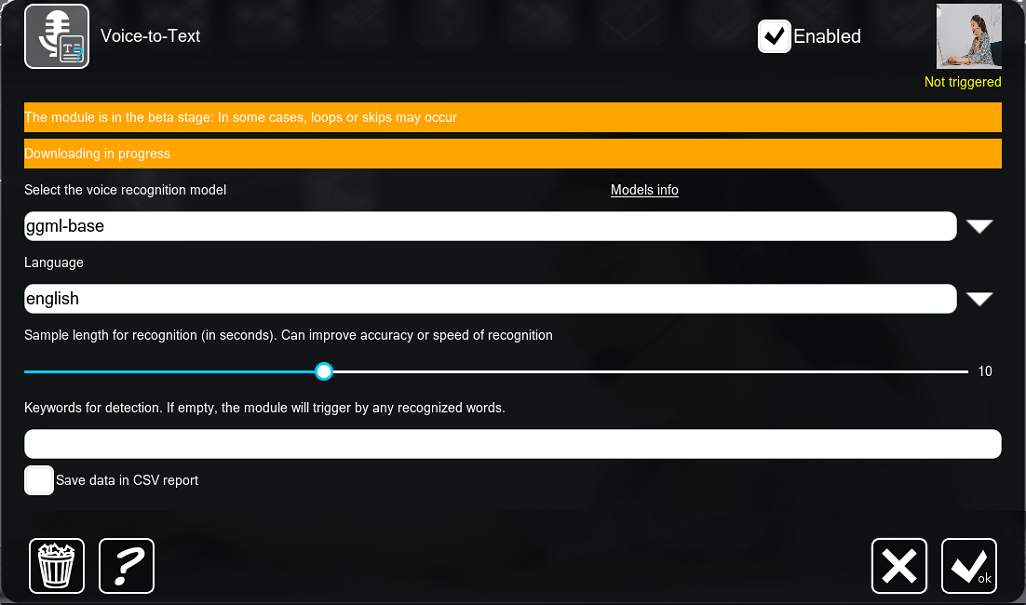
I-click ang Voice-to-Text icon sa chain upang buksan ang module settings. Awtomatikong magsisimula ang pag-download ng mga karagdagang resource sa unang pagbukas ng settings. Kapag nawala na ang mensaheng “Downloading in progress”, handa na ang lahat.
- Ang mga karagdagang resource ay naglalaman ng data arrays para sa artificial intelligence at dina-download on-demand mula sa mga server ng Felenasoft
- Dina-download lamang ang mga resource kapag kailangan — pinapanatili nito na maliit ang size ng programa
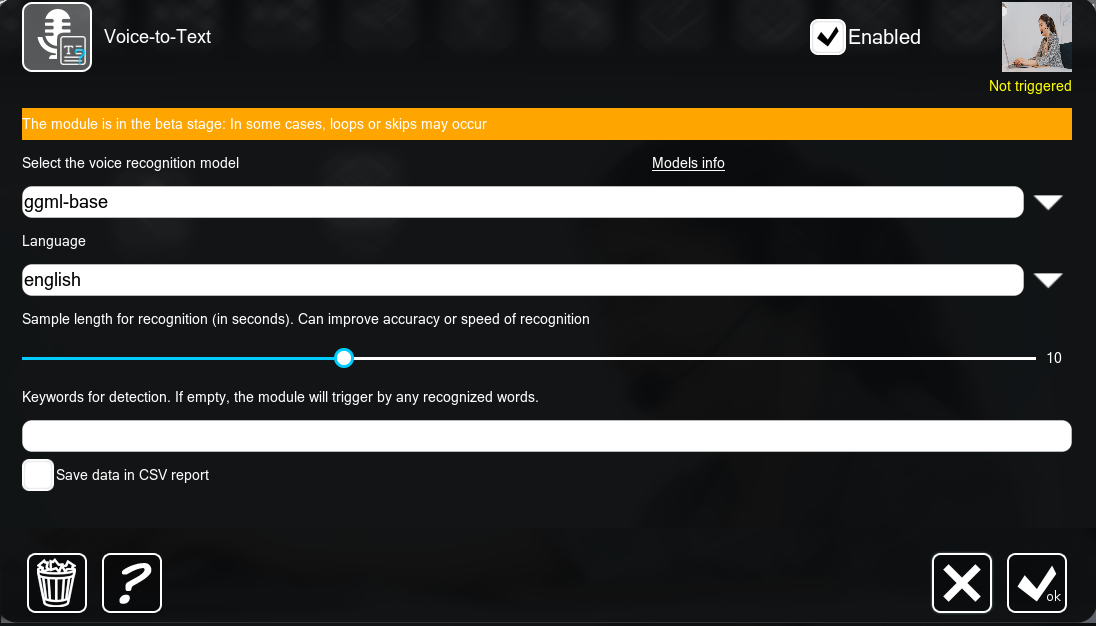
Pumili ng recognition model at mga keyword
May iba't ibang AI model na available para sa magkakaibang wika, na may pagkakaiba sa laki, kalidad ng recognition, at load sa hardware. Sa field na “Speech recognition model”, piliin ang wika ng transcript (hindi na kailangang tukuyin ang wika ng mismong pananalita) at, kung kinakailangan, ilagay ang mga keyword para sa detection sa field sa ibaba. Sa pamamagitan ng mga switch na “Display of recognized speech during real-time viewing” at “Save recognized speech in subtitles when recording/exporting the archive”, maaaring i-overlay ang transcript sa live video at sa archive.
- “Keywords for detection” — tumutugon lamang ang module sa mga salita o pariralang kailangan mo
- Transcript overlay sa live preview at sa archive
- “Save data in CSV report” — ang transcript ay sine-save sa isang spreadsheet file sa disk
- I-connect ang isang reaction pagkatapos ng module: recording, notification, pagpapadala ng command
- Ang
%VOICE%macro ay available sa mga module na “HTTP Request Sender”, “Email Sending” at “Application Runner”
Integrasyon sa mga external program
Maaaring gamitin ang Voice-to-Text mula sa mga external program — halimbawa, para i-transcribe ang mga VoIP conversation. Magbigay ng .mp3 file sa module at kunin ang resulta bilang text — kahit sa mga operator workstation kung saan walang Xeoma o mga camera. Importante: .mp3 files lamang ang suportado.
Halimbawa ng request gamit ang Xeoma API (JSON):
curl -F "audio_file=@speech.mp3" "http://192.168.0.67:10090/api?login=Administrator&password=123&speech_recognition=recognition&model=qwen3-asr-1.7b&ttl=10&language=en"
Saan:
audio_file=@speech.mp3— ang path sa audio file sa iyong computer192.168.0.67— ang IP address ng Xeoma server10090— ang Xeoma server portAdministrator/123— ang login ng Administrator (laging Administrator) at passwordmodel=…— ang recognition model (tingnan ang listahan sa ibaba)language=en— ang wika ng transcript. Kung ito ay iba sa aktwal na wika ng pananalita, awtomatikong isasalin ang transcript sa wikang tinukoy mo
Upang i-save ang resulta bilang text file, idagdag ang >savetext.txt pagkatapos ng command, kung saan ang savetext.txt ay ang pangalan ng text file.
Mga recognition model para sa API:
| Pangalan | Deskripsyon | API code |
|---|---|---|
| Russian basic | 140 MB | tone |
| Russian enhanced | punctuation, 215 MB | giga |
| English basic | 70 MB | zipformer |
| Multilingual basic | punctuation, 1 GB, 0.6B parameters | qwen3-asr-0.6b |
| Multilingual enhanced | punctuation, 2.2 GB, 1.7B parameters | qwen3-asr-1.7b |
Listahan ng mga language code
en — English, zh — Chinese, de — German, es — Spanish, ru — Russian, ko — Korean, fr — French, ja — Japanese, pt — Portuguese, tr — Turkish, pl — Polish, ca — Catalan, nl — Dutch, ar — Arabic, sv — Swedish, it — Italian, id — Indonesian, hi — Hindi, fi — Finnish, vi — Vietnamese, he — Hebrew, uk — Ukrainian, el — Greek, ms — Malay, cs — Czech, ro — Romanian, da — Danish, hu — Hungarian, ta — Tamil, no — Norwegian, th — Thai, ur — Urdu, hr — Croatian, bg — Bulgarian, lt — Lithuanian, la — Latin, mi — Maori, ml — Malayalam, cy — Welsh, sk — Slovak, te — Telugu, fa — Persian, lv — Latvian, bn — Bengali, sr — Serbian, az — Azerbaijani, sl — Slovenian, kn — Kannada, et — Estonian, mk — Macedonian, br — Breton, eu — Basque, is — Icelandic, hy — Armenian, ne — Nepali, mn — Mongolian, bs — Bosnian, kk — Kazakh, sq — Albanian, sw — Swahili, gl — Galician, mr — Marathi, pa — Punjabi, si — Sinhala, km — Khmer, sn — Shona, yo — Yoruba, so — Somali, af — Afrikaans, oc — Occitan, ka — Georgian, be — Belarusian, tg — Tajik, sd — Sindhi, gu — Gujarati, am — Amharic, yi — Yiddish, lo — Lao, uz — Uzbek, fo — Faroese, ht — Haitian Creole, ps — Pashto, tk — Turkmen, nn — Nynorsk, mt — Maltese, sa — Sanskrit, lb — Luxembourgish, my — Myanmar, bo — Tibetan, tl — Tagalog, mg — Malagasy, as — Assamese, tt — Tatar, haw — Hawaiian, ln — Lingala, ha — Hausa, ba — Bashkir, jw — Javanese, su — Sundanese, yue — Cantonese.
Paano mag-test
I-download at i-launch ang Xeoma. Gamitin ang Trial edition o i-activate ang lisensya ng Xeoma Standard/Xeoma Pro + lisensya ng karagdagang module na “Voice-to-text”.
Magdagdag ng camera nang manual o hintayin na mahanap ng Xeoma ang mga camera sa iyong network nang awtomatiko. Para sa hiwalay na mikropono, ikonekta ang module na “Microphone” at piliin ang angkop na sound source.
Idagdag ang module na “Voice-to-Text” sa chain, i-set up ang reaksyon sa mga keyword o continuous speech transcription, at kung kinakailangan, i-enable ang transcript overlay sa imahe ng camera at mga recording.
Magtakda ng reaksyon sa event — pag-save sa CSV, mga notification sa mobile, o iba pa.
demo license
Iba pang module na nagpoproseso ng audio stream
Gumagana ang mga module na ito nang mag-isa o kasabay ng Voice-to-Text.
Pumili ng USB microphone o hiwalay na IP microphone bilang sound source.
Sinusuri ang mga audio stream at nagti-trigger kapag lumampas sa itinakdang limitasyon ang sound level.
Kinikilala ang mga car alarm, iyak ng bata, putok ng baril, tili, at pagbasag ng salamin.
Voice-to-Text: Speech Recognition sa Xeoma
Subukan ang Xeoma nang libre
Ilagay ang iyong pangalan at email para makakuha ng libreng demo license. Hindi kailangan ng credit card.
Kumuha ng libreng demo license ng Xeoma sa email
Kumpletong functionality. Ipinapadala agad.
Hinihimok namin kayong iwasan ang paggamit ng mga email na naglalaman ng personal na data, at ang pagpapadala sa amin ng personal na data sa anumang iba pang paraan. Kung gagawin niyo pa rin ito, sa pag-submit ng form na ito, kinukumpirma niyo ang inyong pahintulot sa pagproseso ng inyong personal na data
May kailangan pa ba kayo?
Hindi ba tugma ang module sa inyong mga pangangailangan? Maaari kaming bumuo ng mga function na kailangan niyo at idagdag ang mga ito sa Xeoma bilang paid development. Tingnan ang detalye.
May mga katanungan? Kailangan ng tulong? Makipag-ugnayan sa amin! Ikalulugod naming tumulong!
Handa nang magsimula?
Subukan ang Voice-to-Text gamit ang libreng demo license — walang credit card at walang personal na data na kinakailangan.