
Ucapan-ke-Teks
Modul pintar Xeoma untuk pengecaman pertuturan
 Modul ini 'mendengar' strim audio daripada kamera atau mikrofon berasingan, mengecam pertuturan, bertindak balas terhadap kata kunci, dan menyimpan transkrip perbualan dalam laporan CSV atau memaparkannya sebagai teks pada video langsung/arkib mengikut pilihan anda. Ia juga boleh mentranskripsi fail .mp3: rakaman perbualan, video latihan, dan lain-lain.

Penting: versi beta
Modul ini tersedia bermula dari Xeoma 24.8.12 dan masih dalam fasa beta, jadi dalam keadaan tertentu ia mungkin melangkau perkataan atau mengalami gelung. Tiada peralatan khusus diperlukan: strim bunyi daripada mana-mana kamera atau mikrofon serta komputer biasa dengan GPU adalah memadai.
Senario aplikasi
Voice-to-Text membantu meningkatkan keselamatan dalam kehidupan peribadi, komuniti bandar, serta sektor komersial, dan menyumbang kepada pengoptimuman operasi perniagaan.
Penjagaan warga emas
Keupayaan untuk bertindak balas serta-merta terhadap jeritan meminta tolong atau melindungi mereka daripada penipu.
Sebarang perniagaan
Kawalan automatik kualiti perkhidmatan pelanggan (contohnya, pengesanan kata-kata kesat).
Pusat panggilan
Transkripsi rakaman panggilan untuk memantau pematuhan terhadap polisi syarikat dan skrip perbualan.
Pengawasan bandar
Keselamatan antipengganas dan pengecaman perkataan yang menandakan bahaya.
Kawalan ibu bapa
Membantu melindungi kanak-kanak daripada buli atau komunikasi dengan penipu.
Polis
Selain kamera badan — transkripsi perbualan dengan suspek dan pengesanan ancaman.
Penyelidikan dan analisis
Pengumpulan statistik latar belakang untuk kajian berkaitan pertuturan dan kekerapan penggunaan perkataan.
Pemasaran
Ketahui sama ada pelanggan membincangkan kempen promosi, reaksi mereka terhadap banner, dan lain-lain.
Penapisan dan automasi
Pengesanan frasa tidak diingini atau kata kunci untuk kawalan perbualan bersasar — tanpa perlu mendengar kesemuanya.
Kelebihan modul Voice-to-Text
Tiada peralatan khas diperlukan
Berfungsi pada komputer biasa dengan hampir semua jenis kamera dan kad grafik.
Fleksibiliti mutlak
Pelbagai tindak balas (termasuk yang boleh diprogramkan sendiri) dan integrasi dengan sistem pihak ketiga.
Operasi masa nyata
Pemprosesan strim secara masa nyata tanpa kependaman. Beroperasi menggunakan perkakasan anda sendiri.
Solusi mampu milik
Modul ini boleh dibeli sebagai tambahan kepada lesen Standard atau Pro.
Cara ia berfungsi
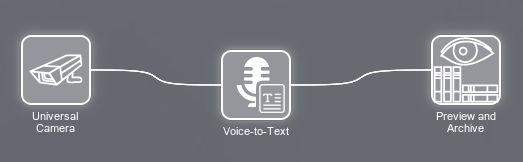
Bina rantai
Memandangkan modul ini memproses strim audio, anda memerlukan sumber bunyi dalam rantai tersebut.
- Sumber bunyi: mikrofon terbina dalam kamera, atau mikrofon USB atau IP berasingan
- Contoh rantai: “Universal Camera” – “Voice-to-Text” – “Preview and Archive”
- Modul ini dilesenkan secara tambahan kepada lesen Xeoma Pro atau Standard
Muat turun sumber AI
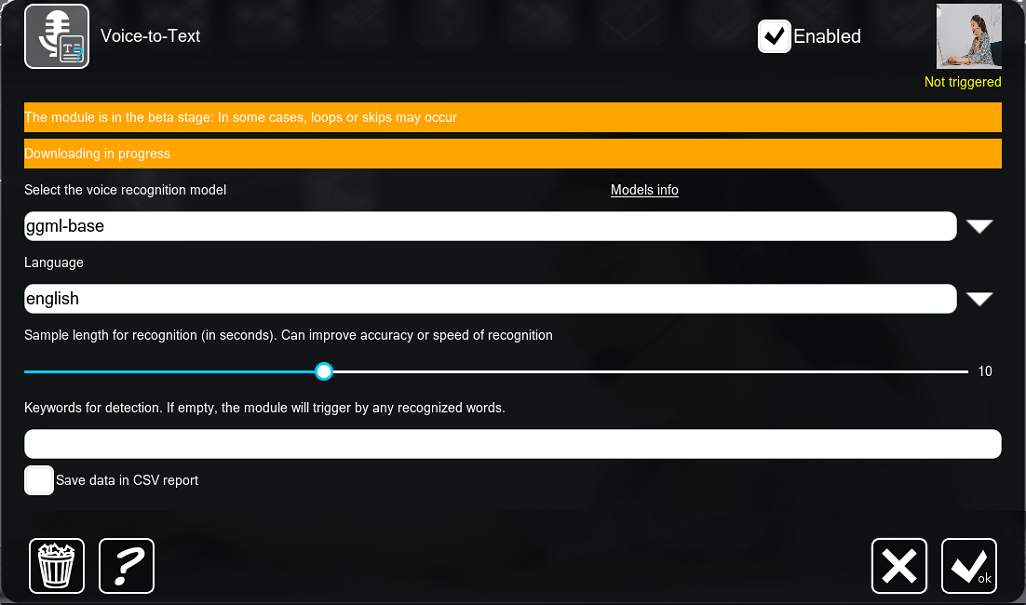
Klik ikon Voice-to-Text dalam rantai untuk membuka tetapan modul. Muat turun sumber tambahan akan bermula secara automatik apabila anda pertama kali membuka tetapan. Apabila mesej “Downloading in progress” hilang, semuanya telah sedia.
- Sumber tambahan mengandungi tatasusunan data untuk kecerdasan buatan dan dimuat turun atas permintaan daripada pelayan FelenaSoft
- Sumber dimuat turun hanya apabila diperlukan — ini memastikan saiz program kekal kecil
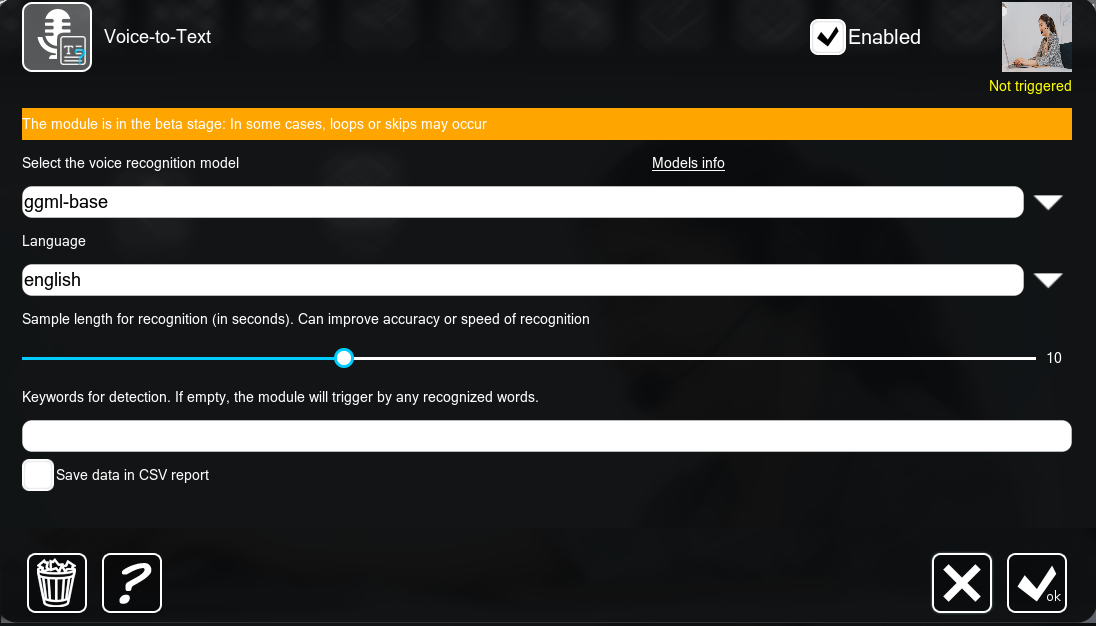
Pilih model pengecaman dan kata kunci
Beberapa model AI tersedia untuk pelbagai bahasa, dengan perbezaan dari segi saiz, kualiti pengecaman, dan beban perkakasan. Dalam medan “Speech recognition model”, pilih bahasa transkrip (bahasa pertuturan sebenar tidak perlu dinyatakan) dan jika perlu, tetapkan kata kunci untuk pengesanan dalam medan di bawah. Suis “Display of recognized speech during real-time viewing” dan “Save recognized speech in subtitles when recording/exporting the archive” membolehkan anda menindihkan transkrip pada video langsung serta dalam arkib.
- “Keywords for detection” — modul hanya bertindak balas terhadap perkataan atau frasa yang anda tentukan
- Tindihan transkrip dalam pratonton langsung dan arkib
- “Save data in CSV report” — transkrip disimpan ke fail hamparan pada cakera
- Sambungkan tindakan selepas modul: rakaman, pemberitahuan, penghantaran arahan
- Makro
%VOICE%tersedia dalam modul “HTTP Request Sender”, “Email Sending” dan “Application Runner”
Integrasi dengan program luaran
Voice-to-Text boleh digunakan dari program luaran — contohnya, untuk mentranskrip perbualan VoIP. Serahkan fail .mp3 kepada modul dan terima hasilnya sebagai teks — walaupun pada stesen kerja operator yang tiada Xeoma atau kamera. Penting: hanya fail .mp3 disokong.
Contoh permintaan melalui Xeoma API (JSON):
curl -F "audio_file=@speech.mp3" "http://192.168.0.67:10090/api?login=Administrator&password=123&speech_recognition=recognition&model=qwen3-asr-1.7b&ttl=10&language=en"
Di mana:
audio_file=@speech.mp3— laluan ke fail audio pada komputer anda192.168.0.67— alamat IP pelayan Xeoma10090— port pelayan XeomaAdministrator/123— log masuk Administrator (sentiasa Administrator) dan kata laluanmodel=…— model pengecaman (lihat senarai di bawah)language=en— bahasa transkrip. Jika berbeza daripada bahasa pertuturan sebenar, transkrip akan diterjemahkan secara automatik ke bahasa yang anda tetapkan
Untuk menyimpan hasil sebagai fail teks, tambahkan >savetext.txt selepas arahan, di mana savetext.txt ialah nama fail teks tersebut.
Model pengecaman untuk API:
| Nama | Penerangan | Kod API |
|---|---|---|
| Rusia asas | 140 MB | tone |
| Rusia dipertingkat | tanda baca, 215 MB | giga |
| Inggeris asas | 70 MB | zipformer |
| Multibahasa asas | tanda baca, 1 GB, 0.6B parameter | qwen3-asr-0.6b |
| Gemma4 pelbagai bahasa dipertingkat | tanda baca, 2.2 GB, 1.7B parameter | qwen3-asr-1.7b |
| Gemma4 pelbagai bahasa asas | tanda baca, 2.2 GB, 1.7B parameter | gemma4-e2b |
| Gemma4 pelbagai bahasa dipertingkat | tanda baca, 7 GB, 12B parameter | gemma4-12b |
Senarai kod bahasa
en — Inggeris, zh — Cina, de — Jerman, es — Sepanyol, ru — Rusia, ko — Korea, fr — Perancis, ja — Jepun, pt — Portugis, tr — Turki, pl — Poland, ca — Catalonia, nl — Belanda, ar — Arab, sv — Sweden, it — Itali, id — Indonesia, hi — Hindi, fi — Finland, vi — Vietnam, he — Ibrani, uk — Ukraine, el — Greek, ms — Melayu, cs — Czech, ro — Romania, da — Denmark, hu — Hungary, ta — Tamil, no — Norway, th — Thai, ur — Urdu, hr — Croatia, bg — Bulgaria, lt — Lithuania, la — Latin, mi — Maori, ml — Malayalam, cy — Wales, sk — Slovak, te — Telugu, fa — Parsi, lv — Latvia, bn — Bengali, sr — Serbia, az — Azerbaijan, sl — Slovenia, kn — Kannada, et — Estonia, mk — Macedonia, br — Breton, eu — Basque, is — Iceland, hy — Armenia, ne — Nepal, mn — Mongolia, bs — Bosnia, kk — Kazakhstan, sq — Albania, sw — Swahili, gl — Galicia, mr — Marathi, pa — Punjabi, si — Sinhala, km — Khmer, sn — Shona, yo — Yoruba, so — Somalia, af — Afrikaans, oc — Occitan, ka — Georgia, be — Belarus, tg — Tajik, sd — Sindhi, gu — Gujarat, am — Amharic, yi — Yiddish, lo — Lao, uz — Uzbekistan, fo — Faroe, ht — Kreol Haiti, ps — Pashto, tk — Turkmen, nn — Nynorsk, mt — Malta, sa — Sanskrit, lb — Luxembourg, my — Myanmar, bo — Tibet, tl — Tagalog, mg — Malagasi, as — Assam, tt — Tatar, haw — Hawaii, ln — Lingala, ha — Hausa, ba — Bashkir, jw — Jawa, su — Sunda, yue — Kantonis
Cara menguji
Muat turun dan lancarkan Xeoma. Gunakan Edisi Percubaan atau aktifkan lesen Xeoma Standard/Xeoma Pro + lesen modul tambahan “Voice-to-text”.
Tambah kamera secara manual atau tunggu Xeoma mengesan kamera dalam rangkaian anda secara automatik. Untuk mikrofon berasingan, sambungkan modul “Microphone” dan pilih sumber audio yang sesuai.
Tambah modul “Voice-to-Text” ke dalam rantaian, tetapkan tindakan bagi kata kunci atau transkripsi pertuturan berterusan, dan jika perlu, aktifkan tindanan transkrip pada imej kamera serta rakaman.
Tetapkan tindakan untuk acara — simpan ke CSV, pemberitahuan mudah alih atau lain-lain.
lesen demo percuma
Modul lain yang memproses aliran audio
Modul ini berfungsi secara kendiri atau bersama Voice-to-Text.
Pilih mikrofon USB atau mikrofon IP berasingan sebagai sumber bunyi.
Menganalisis aliran audio dan mencetuskan amaran apabila paras bunyi melebihi had yang ditetapkan.
Mengecam penggera kereta, tangisan kanak-kanak, tembakan senjata api, jeritan, dan kaca pecah.
Voice-to-Text: Pengecaman Pertuturan dalam Xeoma
Cuba Xeoma secara percuma
Masukkan nama dan e-mel anda untuk mendapatkan lesen demo percuma. Tiada kad kredit diperlukan.
Dapatkan lesen demo percuma Xeoma melalui e-mel
Fungsi penuh. Dihantar serta-merta.
Kami menasihatkan anda agar tidak menggunakan e-mel yang mengandungi data peribadi, atau menghantar data peribadi kepada kami melalui cara lain. Jika anda tetap melakukannya, dengan menghantar borang ini, anda mengesahkan persetujuan anda terhadap pemprosesan data peribadi anda
Perlukan sesuatu yang lain?
Modul ini tidak menepati keperluan anda? Kami boleh membangunkan fungsi yang anda perlukan dan menambahkannya ke dalam Xeoma sebagai pembangunan tersuai berbayar. Lihat butiran.
Ada soalan? Perlukan bantuan? Sila hubungi kami! Kami sedia membantu!
Sedia untuk bermula?
Uji Ucapan-ke-Teks dengan lesen demo percuma — tanpa kad kredit dan tiada data peribadi diperlukan.