
 本モジュールは、カメラや外部マイクからの音声ストリームを「聴取」し、音声を認識してキーワードに反応します。設定に応じて、会話の文字起こし結果をCSVレポートとして保存したり、ライブ映像やアーカイブ上にテキストオーバーレイ表示したりできます。.mp3ファイル(会話の録音や研修動画など)の文字起こしも可能です。

重要:ベータ版
本モジュールはXeoma 24.8.12以降で利用可能ですが、現在はベータ版のため、単語の読み飛ばしやループが発生する場合があります。専用機器は不要で、任意のカメラやマイクからの音声ストリームと、GPUを搭載した一般的なPCで動作します。
活用シナリオ
音声文字起こしは、個人生活、都市・市民の安全、商業分野におけるセキュリティ向上に寄与し、ビジネス業務の最適化にも貢献します。
高齢者の見守り
助けを求める叫び声への即時対応や、詐欺被害からの保護を実現します。
あらゆるビジネス
カスタマーサービスの品質管理を自動化します(例:不適切な発言の検出)。
コールセンター
通話録音を文字起こしし、会社方針やトークスクリプトの遵守状況をモニタリングします。
都市監視
テロ対策セキュリティ強化および危険を示唆する言葉の認識を行います。
ペアレンタルコントロール
いじめ防止や詐欺師との接触を検知し、お子様の保護を支援します。
警察
ボディカメラに加え、容疑者との会話を文字起こしし、脅迫的な発言を検出します。
研究および分析
音声関連の研究や語彙使用頻度の分析に向けた統計データをバックグラウンドで収集します。
マーケティング
顧客がプロモーションキャンペーンについて話題にしているか、バナーへの反応はどうかなどを把握できます。
フィルタリングと自動化
不要なフレーズや重要キーワードを検出し、全会話を聴き直すことなく特定の会話を効率的に管理します。
音声文字起こしモジュールのメリット
専用機器は不要
あらゆるカメラおよびグラフィックボードを搭載した一般的なPCで動作します。
優れた柔軟性
多様な反応(独自プログラミング含む)を設定でき、サードパーティシステムとの連携も可能です。
リアルタイム処理
遅延なくリアルタイムでストリームを処理します。オンプレミスのハードウェアで動作します。
導入しやすいコスト
本モジュールはStandardまたはProライセンスに追加してご購入いただけます。
動作原理
チェーンの構築
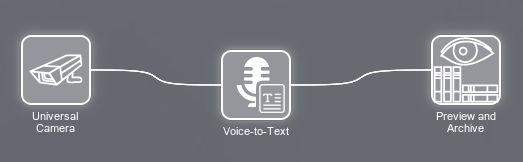
本モジュールは音声ストリームを処理するため、チェーン内に音声ソースが必要です。
- 音声ソース:カメラ内蔵マイク、または外付けUSB/IPマイク
- チェーン構成例:「Universal Camera」 – 「Voice-to-Text」 – 「Preview and Archive」
- 本モジュールのご利用には、ゼオマ Xeoma ProまたはStandardライセンスへの追加ライセンスが必要です
AIリソースのダウンロード
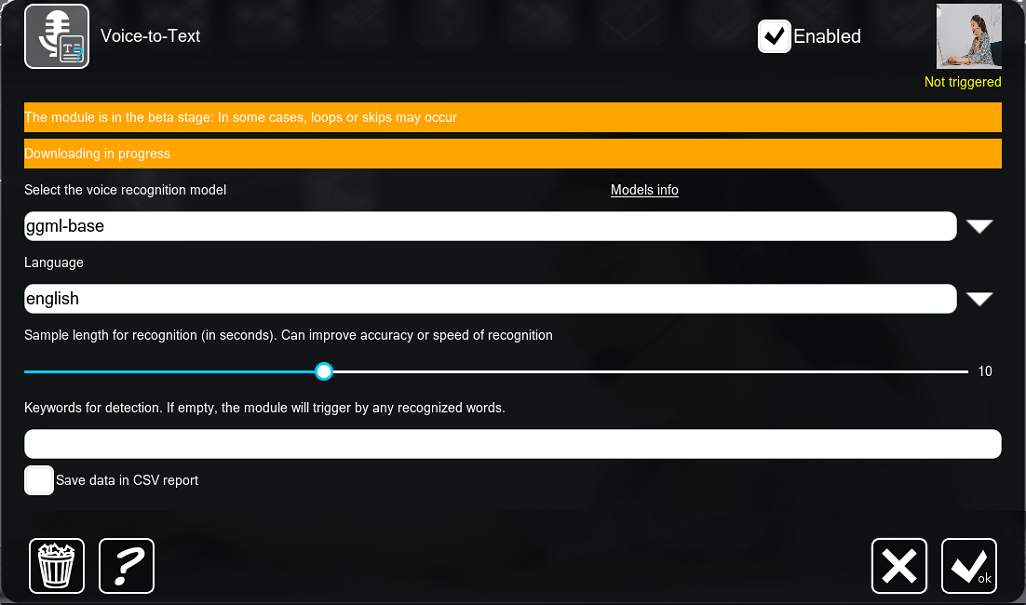
チェーン内の「音声文字起こし」アイコンをクリックしてモジュール設定を開きます。初回設定時に追加リソースのダウンロードが自動開始されます。「Downloading in progress」のメッセージが消えれば準備完了です。
- 追加リソースにはAI用データセットが含まれており、フェレナソフトFelenasoftサーバーから必要に応じてダウンロードされます
- リソースは必要な時にのみダウンロードされるため、プログラムのサイズを最小限に抑えられます
認識モデルとキーワードの選択
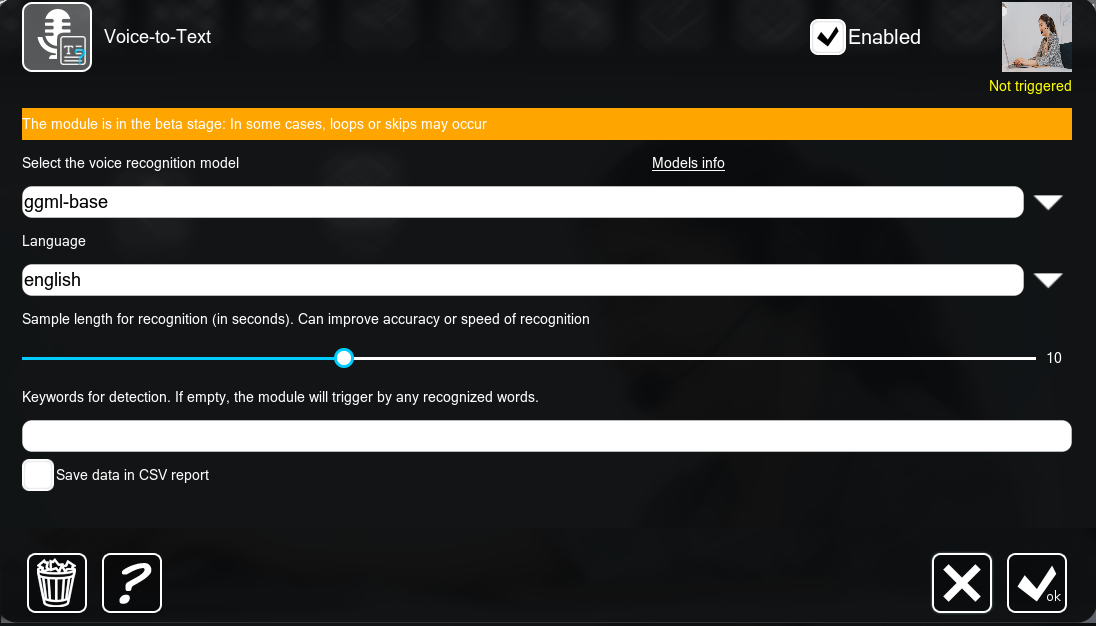
言語ごとに複数の人工知能 (AI) モデルが用意されており、サイズ、認識精度、ハードウェア負荷が異なります。「音声認識モデル」フィールドで書き起こしの言語を選択し(音声自体の言語指定は不要)、必要に応じて下のフィールドに検出キーワードを指定します。「リアルタイム表示中に認識音声を重ねて表示」と「録画・アーカイブ出力時に認識音声を字幕として保存」のスイッチにより、ライブ映像やアーカイブ映像に書き起こしを重ねて表示できます。
- 「検出キーワード」 — 指定した単語やフレーズにのみモジュールが反応します
- ライブプレビューおよびアーカイブへの書き起こしの重ねて表示
- 「CSVレポートにデータを保存」 — 書き起こしがディスク上のスプレッドシートファイルに保存されます
- モジュール実行後のアクション設定:録画、通知、コマンド送信
%VOICE%マクロは、「HTTPリクエスト送信」、「メール送信」、「アプリケーション実行」モジュールで使用できます
外部アプリケーションとの連携
音声文字変換は外部プログラムからも利用可能で、例えばVoIP通話の書き起こしなどに活用できます。モジュールに .mp3 ファイルを渡すだけでテキスト結果を取得できるため、ゼオマ Xeoma やカメラが導入されていないオペレーターの端末でも使用可能です。重要:対応しているのは .mp3 ファイルのみです。
curl -F "audio_file=@speech.mp3" "http://192.168.0.67:10090/api?login=Administrator&password=123&speech_recognition=recognition&model=qwen3-asr-1.7b&ttl=10&language=en"
各項目の説明:
audio_file=@speech.mp3— パソコン上の音声ファイルへのパス192.168.0.67— ゼオマ Xeoma サーバーのIPアドレス10090— ゼオマ Xeoma サーバーのポート番号Administrator/123— 管理者ログイン名(固定でAdministrator)とパスワードmodel=…— 認識モデル(以下のリストを参照)language=en— 書き起こしの言語。実際の発話言語と異なる場合は、指定した言語へ自動翻訳されます
結果をテキストファイルとして保存するには、コマンドの末尾に >savetext.txt を追加します。savetext.txt は任意のテキストファイル名です。
API用 認識モデル一覧:
| 名称 | 説明 | APIコード |
|---|---|---|
| ロシア語 基本 | 140 MB | tone |
| ロシア語 拡張 | 句読点対応、215 MB | giga |
| 英語 基本 | 70 MB | zipformer |
| 多言語 基本 | 句読点対応、1 GB、6億パラメータ | qwen3-asr-0.6b |
| 多言語拡張版 | 句読点対応、2.2 GB、17億パラメータ | qwen3-asr-1.7b |
| Gemma4 多言語基本版 | 句読点対応、2.2 GB、17億パラメータ | gemma4-e2b |
| Gemma4 多言語拡張版 | 句読点対応、7 GB、120億パラメータ | gemma4-12b |
言語コード一覧
en — 英語、zh — 中国語、de — ドイツ語、es — スペイン語、ru — ロシア語、ko — 韓国語、fr — フランス語、ja — 日本語、pt — ポルトガル語、tr — トルコ語、pl — ポーランド語、ca — カタルーニャ語、nl — オランダ語、ar — アラビア語、sv — スウェーデン語、it — イタリア語、id — インドネシア語、hi — ヒンディー語、fi — フィンランド語、vi — ベトナム語、he — ヘブライ語、uk — ウクライナ語、el — ギリシャ語、ms — マレー語、cs — チェコ語、ro — ルーマニア語、da — デンマーク語、hu — ハンガリー語、ta — タミル語、no — ノルウェー語、th — タイ語、ur — ウルドゥー語、hr — クロアチア語、bg — ブルガリア語、lt — リトアニア語、la — ラテン語、mi — マオリ語、ml — マラヤーラム語、cy — ウェールズ語、sk — スロバキア語、te — テルグ語、fa — ペルシャ語、lv — ラトビア語、bn — ベンガル語、sr — セルビア語、az — アゼルバイジャン語、sl — スロベニア語、kn — カンナダ語、et — エストニア語、mk — マケドニア語、br — ブルトン語、eu — バスク語、is — アイスランド語、hy — アルメニア語、ne — ネパール語、mn — モンゴル語、bs — ボスニア語、kk — カザフ語、sq — アルバニア語、sw — スワヒリ語、gl — ガリシア語、mr — マラーティー語、pa — パンジャブ語、si — シンハラ語、km — クメール語、sn — ショナ語、yo — ヨルバ語、so — ソマリ語、af — アフリカーンス語、oc — オック語、ka — ジョージア語、be — ベラルーシ語、tg — タジク語、sd — シンド語、gu — グジャラート語、am — アムハラ語、yi — イディッシュ語、lo — ラオ語、uz — ウズベク語、fo — フェロー語、ht — ハイチ・クレオール語、ps — パシュトゥー語、tk — トルクメン語、nn — ニノシュク、mt — マルタ語、sa — サンスクリット語、lb — ルクセンブルク語、my — ミャンマー語、bo — チベット語、tl — タガログ語、mg — マダガスカル語、as — アッサム語、tt — タタール語、haw — ハワイ語、ln — リンガラ語、ha — ハウサ語、ba — バシキール語、jw — ジャワ語、su — スンダ語、yue — 広東語
テスト方法
デモライセンスを入手
音声ストリームを処理するその他のモジュール
これらのモジュールは単体で、または「音声文字変換」と併用して動作します。
音声文字変換:ゼオマ Xeomaにおける音声認識
ゼオマ Xeomaを無料で試す
名前とメールアドレスを入力して、無料デモライセンスを入手してください。クレジットカードは不要です。
ゼオマ Xeomaの無料デモライセンスをメールで受け取る
全機能利用可能。即時送信されます。
個人データを含むメールアドレスの使用や、その他の方法での個人データ送信はお控えください。万が一送信された場合、本フォームの送信をもって、個人データの処理に同意したものとみなされます
その他ご要望はございますか?
既存のモジュールが要件を満たさない場合もご安心ください。必要な機能の有料カスタム開発を行い、ゼオマ Xeomaに追加することが可能です。詳細を見る。
ご不明な点やお困りのことがございましたら、お問い合わせください!喜んでサポートいたします